
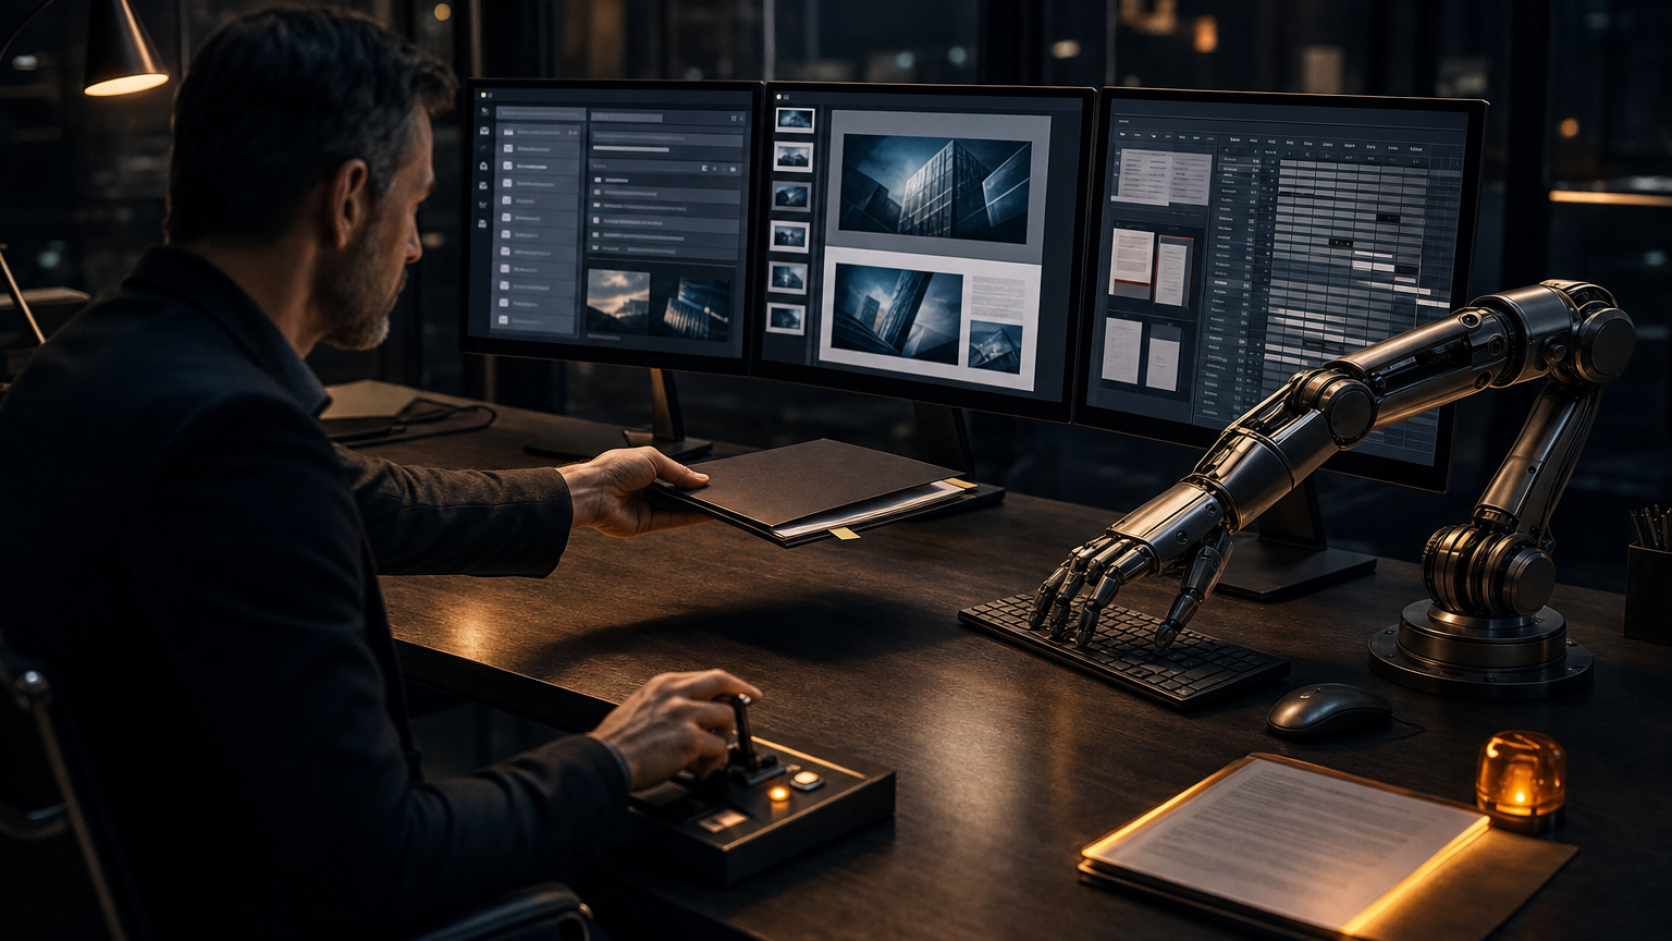
Der Auftrag klingt harmlos: Prüfe die neuen Nachrichten, aktualisiere anhand der Informationen die Präsentation und trage die wichtigsten Änderungen in die Projektübersicht ein. Noch 2023 hätte ein Chatbot höflich erklärt, wie man dabei vorgehen könnte. Im Juli 2026 kann ein entsprechend ausgestattetes KI-System die Arbeit tatsächlich übernehmen. Es öffnet Anwendungen, liest Dateien, ordnet Informationen und fügt alles zu einem Ergebnis zusammen.
Damit verschiebt sich die Rolle künstlicher Intelligenz. Sie formuliert nicht mehr nur Antworten, sondern beginnt zu handeln.
Aktuelle Systeme verarbeiten Texte, Bilder, Sprache, Tabellen und Dokumente gemeinsam. Sie recherchieren im Internet, führen Programme aus und bedienen Software. OpenAI beschreibt seinen im Juli vorgestellten Arbeitsagenten beispielsweise als System, das über Anwendungen und Dateien hinweg aktiv werden, Projekte in Teilschritte zerlegen und über Stunden hinweg bearbeiten kann. Mehr als fünf Millionen Menschen nutzten zu diesem Zeitpunkt den zugrunde liegenden Codex-Dienst wöchentlich; über eine Million davon außerhalb der klassischen Softwareentwicklung. Recherchequelle: OpenAI
Dahinter steckt mehr als eine weitere Produktfunktion. Zwischen Mensch und Computer entsteht eine neue Arbeitsteilung: Der Nutzer benennt das Ziel, die KI sucht nach einem Weg dorthin.
Das Modell bekommt Hände
Für sich genommen kann ein Sprachmodell zunächst nur Ausgaben erzeugen. Es berechnet, welche Wörter, Zeichen oder anderen Informationseinheiten in einem bestimmten Zusammenhang plausibel folgen. Sein Wissen liegt nicht wie in einem Lexikon auf einzelnen Seiten. Es ist in einem mathematischen Geflecht aus Parametern verteilt.
Erst zusätzliche Werkzeuge machen daraus ein handelndes System. Die Suchfunktion liefert aktuelle Informationen, der Rechner übernimmt exakte Berechnungen, eine Programmierumgebung führt Code aus. Über Schnittstellen erhält das Modell zudem Zugriff auf Kalender, Datenbanken oder Unternehmenssoftware. Aus dem antwortenden Modell wird so ein System, das in seiner digitalen Umgebung etwas bewegen kann.
Innerhalb bestimmter Grenzen entscheidet ein KI-Agent selbst, welchen dieser Wege er einschlägt. Anthropic definiert einen solchen Agenten als Modell, das seine Abläufe und den Gebrauch von Werkzeugen eigenständig steuert, statt lediglich einem starren Skript zu folgen. Zugleich warnt das Unternehmen vor Fehlinterpretationen, unbeabsichtigten Aktionen und Angriffen durch manipulierte Anweisungen, sogenannte Prompt-Injections. Recherchequelle: Anthropic
Diese neue Leistungsfähigkeit hat eine klare und folgenreiche Kehrseite: Aus falschen Sätzen können falsche Handlungen werden.
Nennt ein Chatbot einen erfundenen Buchtitel, ist das ärgerlich. Verschiebt ein Agent dagegen die falsche Datei, verändert einen Datensatz oder bereitet eine unzutreffende Zahlung vor, greift der Fehler über die Sprache hinaus – mit konkreten Folgen.
In der Praxis bleiben die meisten Agenten daher noch an einer kurzen Leine. Eine Stack-Overflow-Befragung vom Mai 2026 ergab zwar, dass unter den befragten Entwicklern und Technologen der Anteil mit Agentenerfahrung binnen eines Jahres von 31 auf 59 Prozent gestiegen war. Vollständig unbeaufsichtigt ließen 63 Prozent solche Systeme jedoch selten oder nie arbeiten. 61 Prozent äußerten Sorgen wegen der Genauigkeit. Recherchequelle: Stack Overflow
Beeindruckend – und merkwürdig ungleichmäßig
Die Leistungsgrenzen moderner KI verlaufen nicht wie eine saubere Küstenlinie. Sie sind zerklüftet – und voller überraschender Lücken.
So kann ein Modell anspruchsvollen Programmcode analysieren, wissenschaftliche Dokumente vergleichen oder eine überzeugende Präsentation entwerfen – und kurz darauf an einer einfachen räumlichen Frage scheitern. Auf die Glanzleistung folgt mitunter der Stolperer. Eine allgemeine Zuverlässigkeit lässt sich daraus nicht ableiten.
Wie weit die Fähigkeiten inzwischen reichen, zeigt der AI Index 2026 der Stanford University: Mehrere führende Modelle erreichen oder übertreffen menschliche Vergleichswerte bei Aufgaben aus Wissenschaft, Wettbewerbsmathematik und multimodalem Schlussfolgern, also beim Verknüpfen unterschiedlicher Informationsformen. Gleichzeitig wächst die Lücke zwischen der technischen Entwicklung und ihrer verlässlichen Bewertung. Recherchequelle: Stanford HAI
Besonders deutlich zeigt sich dieser Widerspruch bei Halluzinationen. Mitunter erzeugen Sprachmodelle Daten, Quellen oder Zusammenhänge, die plausibel klingen, aber nicht existieren. In einem vom AI Index ausgewerteten Wissenstest lagen die Halluzinationsraten bei 26 führenden Modellen je nach System zwischen 22 und 94 Prozent. Auf jede Alltagssituation lassen sich solche Werte nicht übertragen. Sie zeigen jedoch, wie stark die Resultate von Aufgabe, Messmethode und Modell abhängen. Recherchequelle: Stanford HAI
Der Grund liegt im Bauprinzip. Ein Sprachmodell besitzt keinen eingebauten Wahrheitsprüfer, sondern erzeugt auf Grundlage gelernter Strukturen eine passende Ausgabe. Recherche, Quellenzugriff und Berechnungswerkzeuge können Fehler deutlich reduzieren. Doch auch dann kann das System eine ungeeignete Quelle wählen oder einen korrekten Beleg falsch deuten.
Die wichtigste Grundregel für den Einsatz lautet deshalb nicht mehr, besonders kunstvolle Eingaben zu formulieren. Vielmehr gilt: Je größer der mögliche Schaden, desto gründlicher muss geprüft werden.
Arbeit wird zur Delegation
Bei traditioneller Software bestimmt der Mensch jeden Schritt. Er öffnet ein Programm, wählt Funktionen aus und bearbeitet das Ergebnis. KI-Agenten kehren dieses Verhältnis teilweise um: Der Mensch beschreibt, was am Ende vorliegen soll. Nicht mehr jeder einzelne Klick zählt, sondern die Klarheit des Auftrags.
Damit verschieben sich die Rollen in der Wissensarbeit. Beschäftigte werden weniger zu Bedienern einzelner Programme und stärker zu Auftraggebern, Kontrolleuren und Redakteuren maschinell erzeugter Zwischenergebnisse. Microsofts Work Trend Index 2026 stützt sich auf eine Befragung unter 20.000 KI nutzenden Wissensarbeitern in zehn Märkten und rückt die menschliche Urteilskraft ins Zentrum. Entscheidend seien klare Absichten, Qualitätsmaßstäbe und eine sinnvolle Aufteilung der Arbeit zwischen Mensch und System. Recherchequelle: Microsoft
Fachwissen verschwindet dabei keineswegs. Im Gegenteil: Wer nicht beurteilen kann, wie ein gutes Ergebnis aussieht, kann nur schwer erkennen, wenn die Maschine überzeugenden Unsinn liefert. KI macht Kontrolle nicht überflüssig. Sie macht gute Kontrolle wertvoller.
Ähnliches gilt für Schulen und Hochschulen. Eine automatisch verfasste Hausarbeit kann Lernen umgehen. Entwickelt ein System dagegen Gegenargumente, erläutert Rechenwege oder hinterfragt einen Text kritisch, kann es das Lernen vertiefen. Ob die Technik zur Abkürzung oder zur Lernhilfe wird, entscheidet die Aufgabenstellung.
Wenn auch Bildern nicht mehr zu trauen ist
Die Verschiebung reicht über Arbeit und Bildung hinaus. Generative KI verändert auch den Status digitaler Aufnahmen: Stimmen lassen sich imitieren, Fotos nahezu ohne sichtbare Spuren erzeugen und Videos gezielt verändern. Was wie ein Beleg aussieht, kann vollständig synthetisch sein. Das Problem besteht jedoch nicht allein darin, dass künstlich erzeugte Medien glaubwürdiger werden. Auch echte Aufnahmen lassen sich leichter als künstlich abtun.
Die Diskussion verlagert sich deshalb von der reinen Erkennung hin zur Überprüfung der Herkunft. Der offene C2PA-Standard sieht kryptografisch gebundene Herkunftsnachweise vor, die Informationen über Entstehung und Bearbeitung einer Datei enthalten können. Solche „Content Credentials“ beweisen nicht automatisch, dass der dargestellte Inhalt wahr ist. Sie können jedoch sichtbar machen, woher eine Datei stammt und welche Veränderungen dokumentiert wurden. Recherchequelle: C2PA
Europa versucht zugleich, verbindliche rechtliche Regeln zu schaffen. Für Anbieter allgemeiner KI-Modelle gelten nach dem AI Act unter anderem Pflichten zur technischen Dokumentation, zur Information nachgelagerter Anbieter, zum Umgang mit dem Urheberrecht und zur Veröffentlichung einer Zusammenfassung der Trainingsinhalte. Die Durchsetzung dieser Vorgaben durch die EU-Kommission soll am 2. August 2026 beginnen. Recherchequelle: Europäische Kommission
Damit rückt die Kernfrage in den Blick: Es geht nicht länger darum, ob KI schreiben, rechnen, sehen oder programmieren kann. Vieles davon kann sie längst.
Wichtiger ist die Frage, welche Befugnisse sie erhalten soll, wie sich Fehler begrenzen lassen und wer verantwortlich bleibt. Je mehr Hände wir der Maschine geben, desto genauer müssen wir darauf achten, wohin sie greift.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
IBM – Was sind KI-Agenten?
Die technische Einführung zeigt, wie Sprachmodelle Aufgaben zerlegen, mehrstufig planen und selbstständig Websuchen, APIs, Datenbanken sowie weitere Werkzeuge einsetzen.
https://www.ibm.com/de-de/think/topics/ai-agents
HMD Praxis der Wirtschaftsinformatik – Bounded Autonomy: Vier Prinzipien für die Governance von KI-Agenten aus der Beratungspraxis
Der Fachbeitrag erläutert Halluzinationen, Prompt-Injections und kaskadierende Fehler und zeigt, weshalb kritische Entscheidungen menschliche Freigaben erfordern.
https://link.springer.com/article/10.1365/s40702-026-01319-3
Ultralytics – Content Credentials (C2PA)
Die technische Übersicht erklärt kryptografisch gebundene Herkunfts- und Bearbeitungsnachweise für Bilder, Videos und Audio sowie deren klare Grenze gegenüber faktischer Wahrheit.
https://www.ultralytics.com/de/glossary/content-credentials-c2pa



