
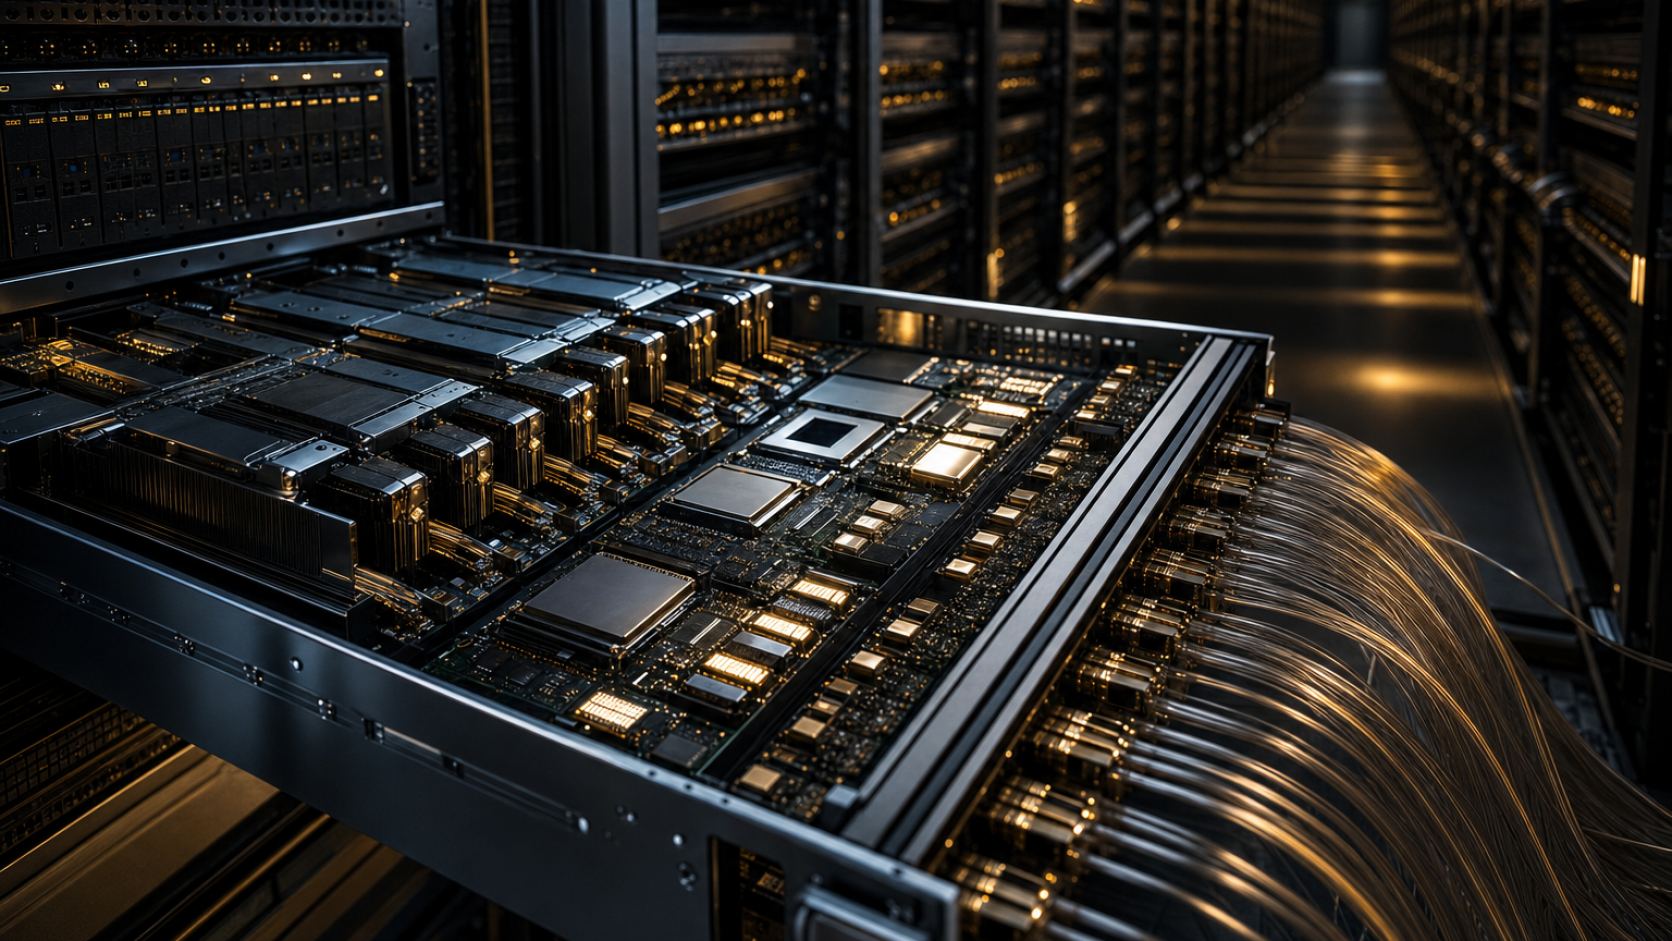
Auf der Bühne in Shanghai schrumpft eine gewaltige Zahl: Nach Huaweis Rechnung genügen 5.500 kompaktere optische Einheiten statt 48.000 herkömmlicher Module, um die Prozessoren des neuen KI-Systems miteinander zu verbinden. Weniger Bauteile, weniger Stromverbrauch, weniger Stellen, an denen etwas ausfallen kann. Zumindest lautet so das Versprechen.
Vorgestellt hat Huawei den Atlas 960E SuperPoD am 17. September auf seiner Hausmesse HUAWEI CONNECT 2026. Bis zu 4.096 KI-Prozessoren sollen darin zusammenarbeiten, als wären sie Teile eines einzigen riesigen Rechners. Dafür setzt der chinesische Konzern erstmals auf Near-Packaged Optics, kurz NPO. Die optischen Verbindungen rücken näher an die Rechenchips heran. Was zunächst wie ein Spezialthema für Ingenieure klingt, zielt auf ein Kernproblem des KI-Booms: Wie lassen sich immer mehr Prozessoren zusammenschalten, ohne dass sie sich gegenseitig ausbremsen? Recherchequelle: huawei.com
Lange galt der Wettlauf um künstliche Intelligenz vor allem als Konkurrenz der einzelnen Chips. Wer besitzt den schnellsten Beschleuniger? Wer kann ihn mit den modernsten Verfahren fertigen? Und wer liefert genügend Exemplare davon? Diese Fragen bleiben wichtig. Sobald jedoch Tausende Prozessoren gemeinsam ein Modell trainieren oder dessen Antworten berechnen, zählt nicht mehr allein die Geschwindigkeit jedes einzelnen Bausteins. Ebenso entscheidend ist, wie rasch die Daten zwischen ihnen fließen.
Ein großer KI-Cluster gleicht einem Orchester, in dem jeder Musiker virtuos spielt, die Töne aber nur mit Verzögerung bei den anderen ankommen. Mehr Instrumente machen die Aufführung dann nicht automatisch besser. Irgendwann wartet jeder auf jeden.
Der Stau zwischen den Prozessoren
Beim Training großer Modelle verteilen sich die Berechnungen auf viele Prozessoren. Sie tauschen Zwischenergebnisse aus, greifen auf gemeinsame Speicherbereiche zu und müssen ihre Arbeit immer wieder aufeinander abstimmen. Mit der Größe des Systems wächst auch der Kommunikationsaufwand. Zusätzliche Rechenleistung bleibt ungenutzt, wenn die Daten nicht schnell genug am richtigen Ort eintreffen.
Huawei beziffert diesen Effekt drastisch: In einem herkömmlich aufgebauten Cluster mit 100.000 KI-Prozessoren könne die interne Kommunikation mehr als 40 Prozent der gesamten Trainingszeit beanspruchen. Unabhängig gemessen wurde dieser von Huawei errechnete Wert nicht. Er macht jedoch deutlich, wo die Branche inzwischen nach Leistungsreserven sucht: nicht allein im Silizium, sondern auf den Wegen dazwischen.
Genau diese Wege soll der Atlas 960E verkürzen. Huaweis NPO-Modul heißt Hi-ONE und bietet laut Hersteller eine Übertragungskapazität von 7,2 Terabit pro Sekunde. Anders als klassische steckbare optische Module sitzt die Technik näher an den Prozessoren oder an jenen Chips, die für die Datenverteilung zuständig sind. Elektrische Signale legen dadurch eine kürzere Strecke zurück, bevor die Informationen optisch weiterreisen. Nach Angaben des Herstellers ermöglicht dies hohe Bandbreiten bei geringerem Strombedarf. Recherchequelle: technode.com
Mit dieser Grundidee ist Huawei nicht allein. In der gesamten Branche rücken Lichtwellenleiter näher an Prozessoren und Netzwerkchips heran. Elektrische Leitungen aus Kupfer sind günstig, vertraut und leicht zu warten, werden bei sehr hohen Datenraten jedoch verlustreicher und energiehungriger. Optische Verbindungen können Informationen dagegen über größere Entfernungen mit hoher Bandbreite übertragen. Dem stehen eine aufwendigere Fertigung, neue Anforderungen an die Kühlung und schwierige Fragen zur Reparatur defekter Komponenten im laufenden Rechenzentrum gegenüber.
Near-Packaged Optics gilt deshalb als Brückentechnik. Die optischen Komponenten befinden sich näher am Rechenchip als bei herkömmlichen Steckmodulen, sind aber nicht mit ihm in einem Gehäuse vereint. Das mindert einige technische Risiken der noch enger integrierten Co-Packaged Optics. Verschwunden sind diese Risiken allerdings nicht: Hitze, Reparierbarkeit, Fertigungsausbeute und die Abhängigkeit von einzelnen Anbietern beschäftigen die Betreiber weiterhin. Recherchequelle: lightwaveonline.com
Ein Rechenzentrum als ein Computer
Huawei blickt dabei über einzelne optische Module hinaus. Beim Atlas 960E kombiniert der Konzern die neue Architektur Peerium mit seinem eigenen Übertragungsprotokoll UnifiedBus. Prozessoren, Arbeitsspeicher, Datenspeicher, Netzwerkkarten und Switches sollen dadurch enger zusammenarbeiten und gemeinsame Speicherbereiche nutzen können.
Das Ziel ist ehrgeizig: Bis zu eine Million Prozessoren sollen einen Verbund bilden, der sich wie ein Rechner verhält. Technisch besteht er selbstverständlich weiterhin aus zahllosen Chips, Platinen, Schränken und Verbindungen. Software und Modelle sollen den Verbund dennoch wie eine weitgehend geschlossene Maschine nutzen können. Ein Atlas-950-Cluster mit 256.000 Karten werde bereits aufgebaut, teilt Huawei mit. Das optisch vernetzte Atlas-960-System befinde sich dagegen noch in der Erprobung. Recherchequelle: huawei.com
Damit bleibt eine wesentliche Einschränkung: Huawei hat keinen unabhängig getesteten Serienrechner präsentiert, der heute in Rechenzentren bestellt und morgen eingeschaltet werden könnte. Vorerst ist der Atlas 960E eine technische Demonstration samt Fahrplan. Auch die versprochenen 8 Exaflops Rechenleistung im FP8-Format, ein Petabyte besonders schnellen HBM-Speichers, 99,8 Prozent Verfügbarkeit und die Einsparung von mehr als 550 Kilowatt beruhen auf Angaben des Herstellers.
Bemerkenswert ist weniger der aktuelle Reifegrad als Huaweis systemischer Ansatz. Statt bloß einen einzelnen Nvidia-Beschleuniger nachzubauen, behandelt der Konzern Rechenchips, Speicher, Verbindungen und Systemsoftware als gemeinsames Problem. Damit folgt er jener Strategie, mit der Nvidia seine starke Stellung ausgebaut hat: Hardware und Infrastruktur werden als abgestimmtes Gesamtsystem entwickelt.
Einen ähnlichen Co-Design-Ansatz verfolgt Nvidia mit seiner Rubin-Plattform. Die sechste Generation der Verbindungstechnik NVLink soll jeden Rubin-Prozessor mit einer Bandbreite von drei Terabyte pro Sekunde anbinden. In einem NVL72-System werden 72 Grafikprozessoren vollständig miteinander vernetzt. Für ein KI-Modell sollen die vielen Chips dadurch wie ein einziger großer Beschleuniger erscheinen. Recherchequelle: nvidia.com
Der Unterschied liegt weniger im Grundprinzip als in der Größenordnung und im politischen Umfeld. Huawei will seine Architektur weit über einzelne Serverschränke hinaus ausdehnen. Zugleich baut China seine KI-Infrastruktur unter erschwerten Bedingungen auf, weil der Zugang zu besonders fortschrittlichen westlichen Prozessoren und Fertigungsanlagen eingeschränkt ist. Für Huawei wächst damit der Anreiz, die verfügbaren Chips möglichst effizient zusammenarbeiten zu lassen. Die Associated Press ordnet die Vorstellung entsprechend in den sich verschärfenden Wettbewerb mit Nvidia ein und verbindet sie mit Chinas Streben nach technologischer Eigenständigkeit. Recherchequelle: apnews.com
An Huaweis optischer Offensive lässt sich ablesen, wie sich der Maßstab der KI-Industrie verschiebt: weg vom einzelnen Spitzenchip, hin zum möglichst leistungsfähigen Gesamtsystem. Der wichtigste Baustein muss nicht der schnellste einzelne Chip sein. Vielleicht ist es das System, das mittelstarke Chips so geschickt verbindet, dass sie gemeinsam kaum noch warten müssen.
Die großen KI-Rechner der kommenden Jahre werden nicht nur mehr rechnen. Sie werden auch dichter, heißer und komplizierter. In ihrem Inneren müssen gewaltige Datenströme nahezu ohne Unterbrechung fließen. Ein Teil des globalen KI-Wettlaufs entscheidet sich deshalb an unscheinbaren Orten: zwischen Prozessor und Speicher, zwischen Kupfer und Glasfaser – in Lichtimpulsen, die kaum jemand sieht.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
Dr. Web – Licht statt Stecker: Huawei bündelt 4.096 KI-Chips zum Supernode
Der Beitrag erläutert die NPO-Vernetzung von 4.096 KI-Chips und beziffert die Einsparungen bei optischen Modulen, Stromverbrauch und Ausfallrisiko.
https://www.drweb.de/huawei-ascend-960-ki-supernode/
Golem.de – Angriff auf Nvidia: Huawei stellt leistungsfähige Ascend-960-Serie vor
Der Fachbeitrag erklärt UnifiedBus 2.0, die gemeinsame Nutzung großer Prozessorverbünde und die geplante Skalierung auf bis zu eine Million KI-Prozessoren.
https://www.golem.de/news/angriff-auf-nvidia-huawei-stellt-leistungsfaehige-ascend-960-serie-vor-2609-213145.html
NVIDIA Blog – NVIDIA DGX SuperPOD schafft die Voraussetzungen für Rubin-basierte Systeme
Der technische Überblick vertieft Nvidias konkurrierenden Co-Design-Ansatz aus Vera-CPU, Rubin-GPU, NVLink 6, Netzwerkkomponenten und Systemsoftware.
https://blogs.nvidia.de/dgx-superpod-rubin/



