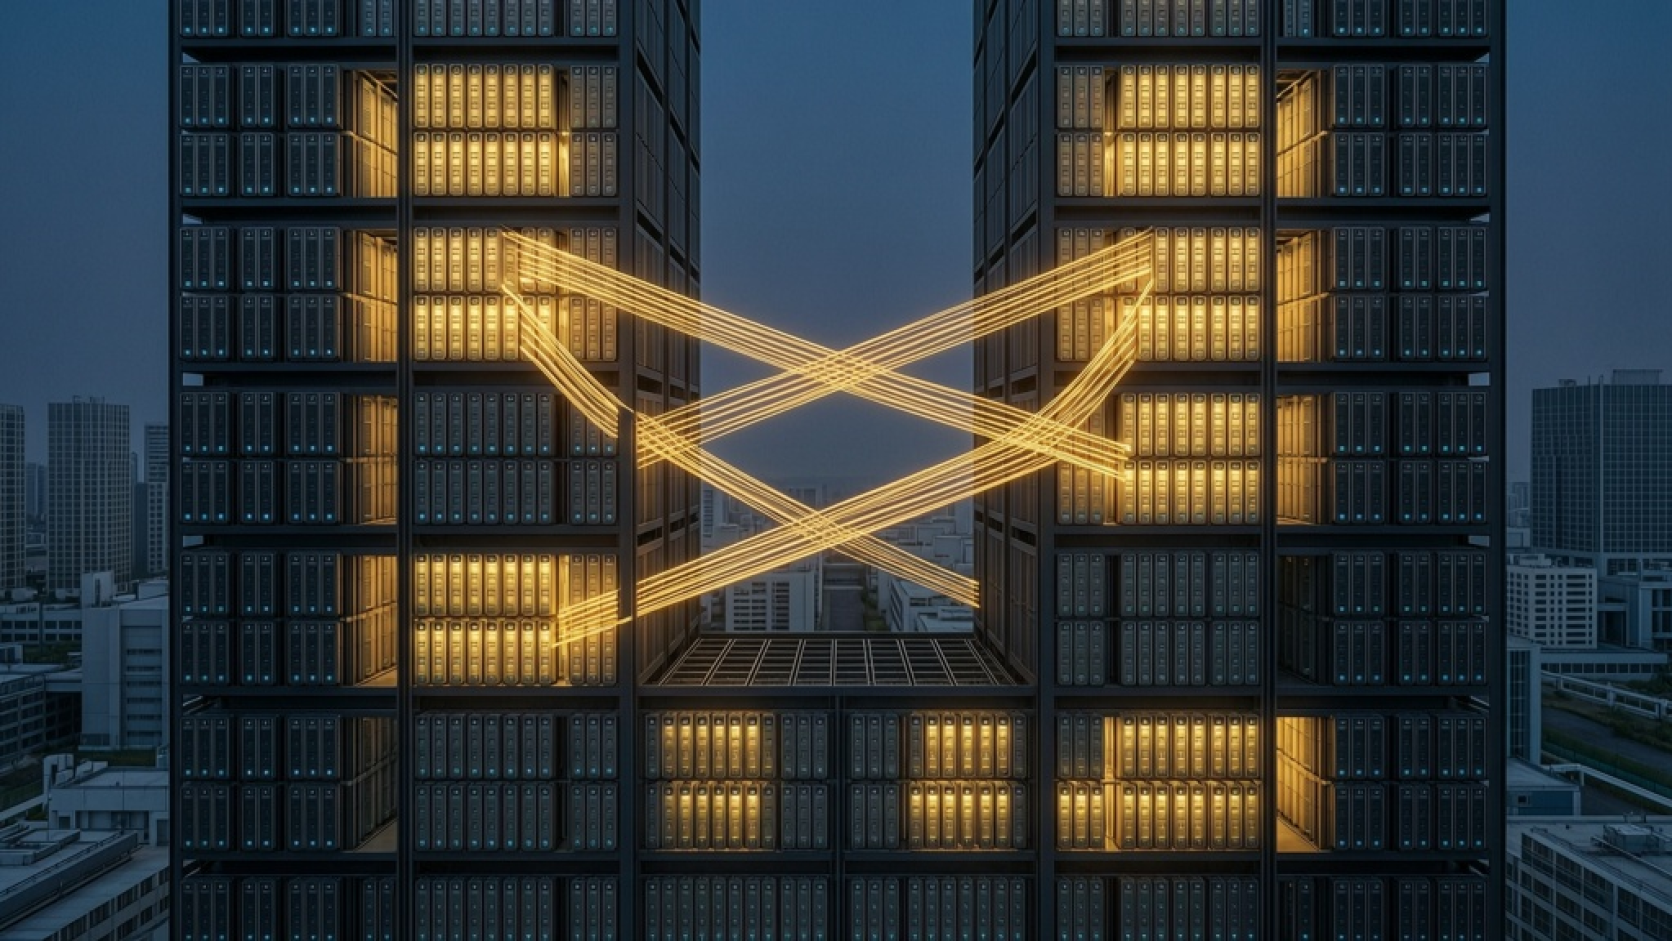
Eine Billion Parameter. Die Zahl ragt wie ein Hochhaus auf und stellt fast jede andere Information in den Schatten. Doch bei Mistral Large 4 sind für eine einzelne Anfrage nur einige Etagen beleuchtet: Aktiviert wird jeweils nur ein Bruchteil des Modells. Genau das ist der entscheidende Punkt.
Mistrals neues Spitzenmodell in Zahlen
Das französische Unternehmen Mistral AI hat sein neues Spitzenmodell am 6. Oktober 2026 für eine öffentliche Vorschau freigegeben. Large 4, intern augenzwinkernd „Le Chonk“ genannt, soll Texte und Bilder verarbeiten, programmieren, Werkzeuge bedienen und komplexe Dokumente auswerten können. Mistral spricht von einer Billion Parametern, von denen jeweils 49 Milliarden aktiv seien. Trainiert wurde das Modell nach Angaben des Unternehmens auf 3.800 Nvidia-Grafikprozessoren in eigenen europäischen Rechenzentren. Die Trainingsdaten enthielten Inhalte in mehr als 160 Sprachen, darunter sämtliche Amtssprachen der Europäischen Union. Recherchequelle: Mistral AI
Schon bei den technischen Angaben geraten die Zahlen allerdings ein wenig ins Rutschen. Mistrals Dokumentation nennt derzeit 1,05 Billionen Gesamtparameter und 52 Milliarden aktive Parameter. In der Veröffentlichung ist dagegen gerundet von einer Billion Gesamtparametern und 49 Milliarden aktiven Parametern die Rede. Ob unterschiedliche Versionsstände oder eine andere Zählweise dahinterstecken, erklärt das Unternehmen bislang nicht. An der grundsätzlichen Einordnung ändert die Abweichung wenig. Bemerkenswert bleibt sie dennoch, gerade weil der Hersteller seine Architektur mit großen Zahlen bewirbt.
Laut Dokumentation ist Large 4 ein multimodales Mixture-of-Experts-Modell mit einem Kontextfenster von einer Million Token. Unterstützt werden unter anderem strukturierte Ausgaben, Werkzeugaufrufe, Dokumentenanalysen und Mistrals Schnittstellen für KI-Anwendungen. Noch befindet sich das Modell ausdrücklich in einer öffentlichen Vorschau. Recherchequelle: Mistral-Dokumentation
Wie das Modell seine Experten auswählt
Der Begriff „Mixture of Experts“ klingt zunächst nach einem digitalen Konferenzraum, in dem sich Experten für Recht, Mathematik und Programmierung beraten. Das Bild hilft beim Verständnis, solange man es nicht zu wörtlich nimmt. Denn die einzelnen Teilnetze sind keine Persönlichkeiten mit klar abgegrenzten Fachgebieten, sondern Gruppen von Parametern, die während des Trainings unterschiedliche Muster erlernen können.
Bei der Verarbeitung jedes Tokens entscheidet eine vorgeschaltete Steuerung, welche dieser Gruppen zum Einsatz kommen. Das gesamte Netz rechnet also nicht gleichzeitig. Stattdessen wird eine begrenzte Auswahl aktiviert; anschließend fließen deren Ergebnisse zusammen. Mistral beschrieb dieses Prinzip bereits 2023 bei seinem Modell Mixtral. Damals wählte ein sogenannter Router für jeden Token zwei von acht Parametergruppen aus. So stieg die Gesamtkapazität, ohne dass bei jeder Ausgabe die Rechenkosten eines vollständig aktiven Modells anfielen. Recherchequelle: Mistral AI
Large 4 überträgt dieses Prinzip nun auf eine Größenordnung, in der die reine Parameterzahl deutlich an Aussagekraft verliert. Ein Modell mit einer Billion Parametern muss nicht denselben Rechenaufwand verursachen wie ein dichtes Modell, bei dem sämtliche Gewichte an jedem Verarbeitungsschritt beteiligt sind. Die Billion steht eher für den gesamten verfügbaren Maschinenpark als für die Anlagen, die gerade laufen.
Warum Größe allein kein Maßstab mehr ist
Damit werden Vergleiche schwieriger. In den vergangenen Jahren diente die Parameterzahl oft als leicht verständliche Abkürzung für Fortschritt: mehr Parameter, größeres Modell, vermutlich höhere Leistung. Bei sparsamen Architekturen zerfällt diese einfache Rangordnung. Andere Faktoren gewinnen an Gewicht: die Zahl der aktiven Parameter, die Qualität des Trainings, die Auswahl der Daten, die Geschwindigkeit und die Fähigkeit des Routers, für eine Aufgabe die geeigneten Modellbereiche anzusprechen.
Auch ein großes Parameterreservoir garantiert noch keine gute Antwort. Es kann viele Muster speichern und unterschiedliche Aufgaben abdecken. Ob daraus verlässliche Ergebnisse entstehen, zeigt sich aber erst in unabhängigen Prüfungen und im praktischen Einsatz. Schließlich spielt ein Orchester nicht allein deshalb besser, weil ihm mehr Instrumente zur Verfügung stehen.
CjxkaXYgY2xhc3M9ImV4dGhvcmlhLWFtYXpvbi1hZCIgZGF0YS1leHRob3JpYS1hZC1zbG90PSIwMSIgZGF0YS1leHRob3JpYS1hZC1wcm92aWRlcj0iYW1hem9uIj48ZGl2IGNsYXNzPSJleHRob3JpYS1hbWF6b24tYWRfX21ldGEiPjxzcGFuIGNsYXNzPSJleHRob3JpYS1hbWF6b24tYWRfX2JhZGdlIj5XZXJidW5nPC9zcGFuPjxzcGFuIGNsYXNzPSJleHRob3JpYS1hbWF6b24tYWRfX3Byb3ZpZGVyIj5BbWF6b248L3NwYW4+PC9kaXY+PHN0cm9uZyBjbGFzcz0iZXh0aG9yaWEtYW1hem9uLWFkX190aXRsZSI+VW50ZXIgZGVyIEhhdWJlIHZvbiBMYXJnZSBMYW5ndWFnZSBNb2RlbHM6IEFyY2hpdGVrdHVyZW4sIFRyYWluaW5nc2dydW5kbGFnZW4gdW5kIG11bHRpbW9kYWxlIEZvcnRzY2hyaXR0ZTogUHJha3Rpc2NoZSBFaW5ibGlja2UgaW4gZGllIE1vZGVsbGUsIGRpZSBHUFQsIExMYU1BLCBNaXN0cmFsIHVuZCBtZWhyIGFuPC9zdHJvbmc+PGEgY2xhc3M9ImV4dGhvcmlhLWFtYXpvbi1hZF9fY3RhIiBocmVmPSJodHRwczovL2xpbmsuYW1hem9uL0IwMEtYZ1p3cSIgdGFyZ2V0PSJfYmxhbmsiIHJlbD0ic3BvbnNvcmVkIG5vZm9sbG93IG5vb3BlbmVyIG5vcmVmZXJyZXIiIGRhdGEtZXh0aG9yaWEtbGluay1tYW5hZ2VyPSIxIiBkYXRhLWV4dGhvcmlhLWxpbmstdHlwZT0iZXh0ZXJuYWwiIGRhdGEtZXh0aG9yaWEtYWQtbGluaz0iYW1hem9uIj5CZWkgQW1hem9uIGFuc2VoZW4gPHNwYW4+KGJlemFobHRlciBMaW5rKTwvc3Bhbj48L2E+PHNtYWxsIGNsYXNzPSJleHRob3JpYS1hbWF6b24tYWRfX2Rpc2Nsb3N1cmUiPsOcYmVyIHVuc2VyZSBBbWF6b24tUGFydG5lcmxpbmtzIGVyaGFsdGVuIHdpciBiZWkgcXVhbGlmaXppZXJ0ZW4gVmVya8OkdWZlbiBlaW5lIFByb3Zpc2lvbi48L3NtYWxsPjwvZGl2Pgo=Mistral hebt vor allem Leistungen beim Programmieren, in der Cybersicherheit und im Finanzbereich sowie bei der Verarbeitung visueller Informationen hervor. Die zum Start veröffentlichten Vergleiche stammen jedoch überwiegend vom Unternehmen selbst oder von Partnern, deren Tests Mistral für seine Präsentation ausgewählt hat. Wie TechCrunch berichtete, standen umfassendere Benchmark-Ergebnisse zum Zeitpunkt der Vorstellung noch aus. Zudem war das Modell bislang nur über eine abgesicherte Schnittstelle zugänglich. Am 7. Oktober war Large 4 noch nicht frei herunterladbar. Recherchequelle: TechCrunch
Offene Gewichte, offene Fragen
Damit rückt eine zweite Frage ins Licht, bei der die KI-Branche gern großzügig formuliert: Wie offen ist das Modell tatsächlich?
Mistral bezeichnet Large 4 als Open-Weight-Modell. Die Gewichte sollen nach einer Testphase veröffentlicht werden, in der ausgewählte Partner, Sicherheitsexperten und staatliche Stellen das Modell mit erweiterten Fähigkeiten untersuchen. Das Unternehmen selbst nennt lediglich das Ende des Monats. Reuters gibt den 27. Oktober als vorgesehenen Veröffentlichungstermin an. Recherchequelle: Reuters bei Euronext
Bis dahin bleibt „Open-Weight“ ein Versprechen mit Datum. Entwickler können die Vorschau zwar ausprobieren, das vollständige Modell aber noch nicht herunterladen, auf eigener Hardware betreiben oder unabhängig von Mistrals Infrastruktur untersuchen. Eine solche Kontrolle wäre erst möglich, wenn die Gewichte tatsächlich veröffentlicht sind.
Doch selbst dann wäre Large 4 nicht zwangsläufig in jeder Hinsicht offen. Zugängliche Gewichte sind nicht dasselbe wie eine vollständige Offenlegung der Trainingsdaten, Filterverfahren und Entwicklungsschritte. Sie ermöglichen allerdings etwas, das bei geschlossenen Modellen kaum möglich ist: Unternehmen und Forschungsteams können das Modell auf eigener Infrastruktur untersuchen, anpassen und betreiben. Den Zugriff auf ein bereits heruntergeladenes Modell kann der Anbieter nicht einfach durch eine geänderte Schnittstelle oder neue Geschäftsbedingungen abschalten.
Europas KI-Anspruch trifft auf globale Abhängigkeiten
Hier nimmt Mistrals europäischer Anspruch Gestalt an. Das Unternehmen will nicht nur ein leistungsfähiges Modell anbieten, sondern eine Alternative zu den weitgehend geschlossenen Systemen amerikanischer Konzerne und zu den inzwischen starken offenen Modellen aus China. Le Monde beschreibt Large 4 als Versuch, den Abstand zu den führenden chinesischen Wettbewerbern zu verkleinern. Nach eigener Darstellung liegt Mistral auf einzelnen Feldern wie der Cybersicherheit bereits vorn. Solange unabhängige Tests fehlen, bleibt das eine Herstellerangabe, keine gesicherte Rangliste. Link temporarily unavailable
Jenseits solcher Leistungsvergleiche ist auch die Herkunft des Modells relevant. Large 4 wurde laut Mistral nicht nur in Europa entwickelt, sondern auch auf eigener europäischer Infrastruktur trainiert und bereitgestellt. Das verschafft dem Unternehmen mehr technische Kontrolle, bedeutet aber noch keine vollständige Unabhängigkeit. In den Rechenzentren arbeiten Grace-Blackwell-Systeme des amerikanischen Chipherstellers Nvidia. Europas KI-Souveränität steht damit auf importiertem Silizium.
Dieses Spannungsverhältnis schmälert die technische Leistung nicht. Es zeigt jedoch, wie viele Ebenen zwischen einem Modell und echter Unabhängigkeit liegen: Chips, Stromversorgung, Rechenzentren, Softwarebibliotheken, Trainingsdaten, Kapital und Fachwissen. Ein europäisches Modell kann in einigen dieser Bereiche eigenständig sein und in anderen weiterhin von Lieferanten außerhalb Europas abhängen.
Large 4 verdient deshalb mehr Aufmerksamkeit als eine gewöhnliche Modellankündigung. Der KI-Wettbewerb entscheidet sich längst nicht mehr nur daran, wer die klügsten Antworten liefert. Ebenso wichtig ist, wem die Infrastruktur gehört, wer ein Modell prüfen darf und wer im Ernstfall den Schalter kontrolliert.
Im Gedächtnis bleibt dennoch die Billion. Sie ist rund, gewaltig und griffig genug für jede Überschrift. Wichtiger ist jedoch die kleinere Zahl: die 49 Milliarden Parameter, die laut Veröffentlichung tatsächlich aktiv sind, wenn ein Nutzer eine Frage stellt. Large 4 deutet damit an, wie sich große KI-Systeme weiterentwickeln. Sie wachsen weiter, aber nicht mehr unbedingt als ein einziger massiver Block. Ihre Größe verteilt sich auf viele Räume, von denen immer nur einige erleuchtet sind.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
Fello AI – Mistral Large 4: Specs, Benchmarks, Preis und wann die Gewichte kommen
Der technische Überblick erläutert die MoE-Architektur, die abweichenden Angaben von 49 beziehungsweise 52 Milliarden aktiven Parametern und das angekündigte Kontextfenster von einer Million Token.
https://felloai.com/de/mistral-large-4/
THE DECODER – Mistral Large 4 soll das stärkste offene KI-Modell aus Europa und den USA sein
Der Fachartikel ordnet den aktuellen API-Zugang, die für Ende Oktober angekündigte Gewichtsfreigabe und die noch unbekannten Lizenzbedingungen ein.
https://the-decoder.de/mistral-large-4-soll-das-staerkste-offene-ki-modell-aus-europa-und-den-usa-sein/
heise online – KI-Update Deep-Dive: Hardware-Engpässe und Machtspiele auf dem KI-Markt
Die Analyse erklärt, wie Nvidias Hardware- und Softwaredominanz sowie mögliche Exportbeschränkungen Europas technologische Souveränität begrenzen.
https://www.heise.de/news/KI-Update-Deep-Dive-Hardware-Engpaesse-und-Machtspiele-auf-dem-KI-Markt-10306448.html