Das Gedächtnis der Videomodelle: Warum KI-Figuren zwischen zwei Einstellungen ihr Gesicht verlieren
Unterzeile: Google und Alibaba wollen Figuren mithilfe von Referenzbildern über mehrere Szenen hinweg stabil halten. Doch selbst die Anbieter räumen ein, dass Perspektivwechsel, Kameraschwenks und neue Umgebungen die visuelle Identität der Figuren weiterhin ins Wanken bringen.
Warum dieses Thema genau am 1. Juli 2026 aktuell war
Den unmittelbaren Nachrichtenanlass lieferte Google am 30. Juni 2026: Gemini Omni Flash wurde erstmals über die Gemini API und Google AI Studio für Entwickler bereitgestellt. Dabei hob Google multimodale Referenzen aus Bildern, Texten und Videos hervor, mit denen sich eine Szene gezielter weiterbearbeiten lässt. Zugleich benannte das Unternehmen ausdrücklich eine entscheidende Grenze: Beim Wechsel der Szene und bei Kameraschwenks sei die Konsistenz von Figuren noch eingeschränkt. Recherchequelle: blog.google
Nur kurz zuvor hatte Alibaba mit HappyHorse 1.1 einen konkurrierenden Ansatz vorgestellt. Dessen Reference-to-Video-Modus sollte mehrere Referenzbilder verwenden, um Figuren, Szenen und visuelle Stile stabiler zu reproduzieren. So standen sich am 1. Juli zwei unterschiedliche Versprechen gegenüber: Google setzte auf multimodalen Kontext und aufeinanderfolgende Bearbeitungsschritte, Alibaba dagegen auf eine größere Sammlung visueller Identitätsanker. Recherchequelle: Alibaba Cloud Community
Journalistisch entscheidend ist deshalb nicht die Veröffentlichung eines weiteren Videomodells. Spannender ist die ungelöste Schwäche dahinter:
Trotz immer realistischerer Einzelclips haben KI-Videomodelle weiterhin Schwierigkeiten, eine Figur über Schnitte, Blickwinkel und Beleuchtungssituationen hinweg als dieselbe Person zu behandeln.
Die zentrale These des Artikels
KI-Video leidet inzwischen weniger an mangelnder Bildqualität als an fehlender Kontinuität.
Ein Modell kann eine überzeugende zehnsekündige Szene erzeugen. Für eine längere Geschichte reicht das jedoch nicht. Dann muss es auseinanderhalten können, was zu einer Figur gehört und was sich von Einstellung zu Einstellung verändern darf. Es geht dabei um:
unveränderliche Identitätsmerkmale wie Gesicht, Körperbau und prägende Besonderheiten,
veränderliche Zustände wie Mimik, Haltung und Bewegung,
Kostüm und Requisiten,
Inszenierungsfaktoren wie Kamera, Beleuchtung und Umgebung,
Informationen, die auf einem einzelnen Referenzbild nicht sichtbar sind.
Ein frontales Porträt verrät beispielsweise kaum, wie eine Person im Profil oder von hinten aussehen soll. Für den nächsten Clip muss das Modell die fehlenden Informationen ergänzen. Genau an dieser Leerstelle beginnt die Identität zu verrutschen: Häufig entsteht keine weitere Aufnahme derselben Figur, sondern eine neue Figur, die ihr lediglich ähnelt.
Die entscheidende journalistische Frage
Lösen Referenzbilder das Problem tatsächlich – oder halten sie es nur in Grenzen?
Alibaba bewarb HappyHorse 1.1 insbesondere mit der Möglichkeit, mehrere Bildreferenzen zu nutzen und die Identität einer Figur über generierte Szenen hinweg stabiler zu halten. VentureBeat ordnete gerade diese Reference-to-Video-Funktion als Antwort auf eines der größten Probleme der kommerziellen KI-Videoproduktion ein. Recherchequelle: VentureBeat
Im Zentrum stehen sechs Fragen:
1. Was speichert ein Videomodell eigentlich von einer Figur?
2. Warum genügt eine genaue Personenbeschreibung nicht?
3. Was leisten ein einzelnes Referenzbild, mehrere Ansichten und ein Referenzvideo jeweils?
4. Warum verändern sich Gesicht, Kleidung oder Requisiten besonders bei Schnitten?
5. Ist Figurenkonsistenz eine Modelleigenschaft – oder inzwischen eine eigene Produktionsaufgabe?
6. Wie viel manuelle Vorbereitung bleibt trotz der neuen Funktionen notwendig?
Sinnvoller Aufbau des Artikels
1. Der unsichtbare Darstellerwechsel
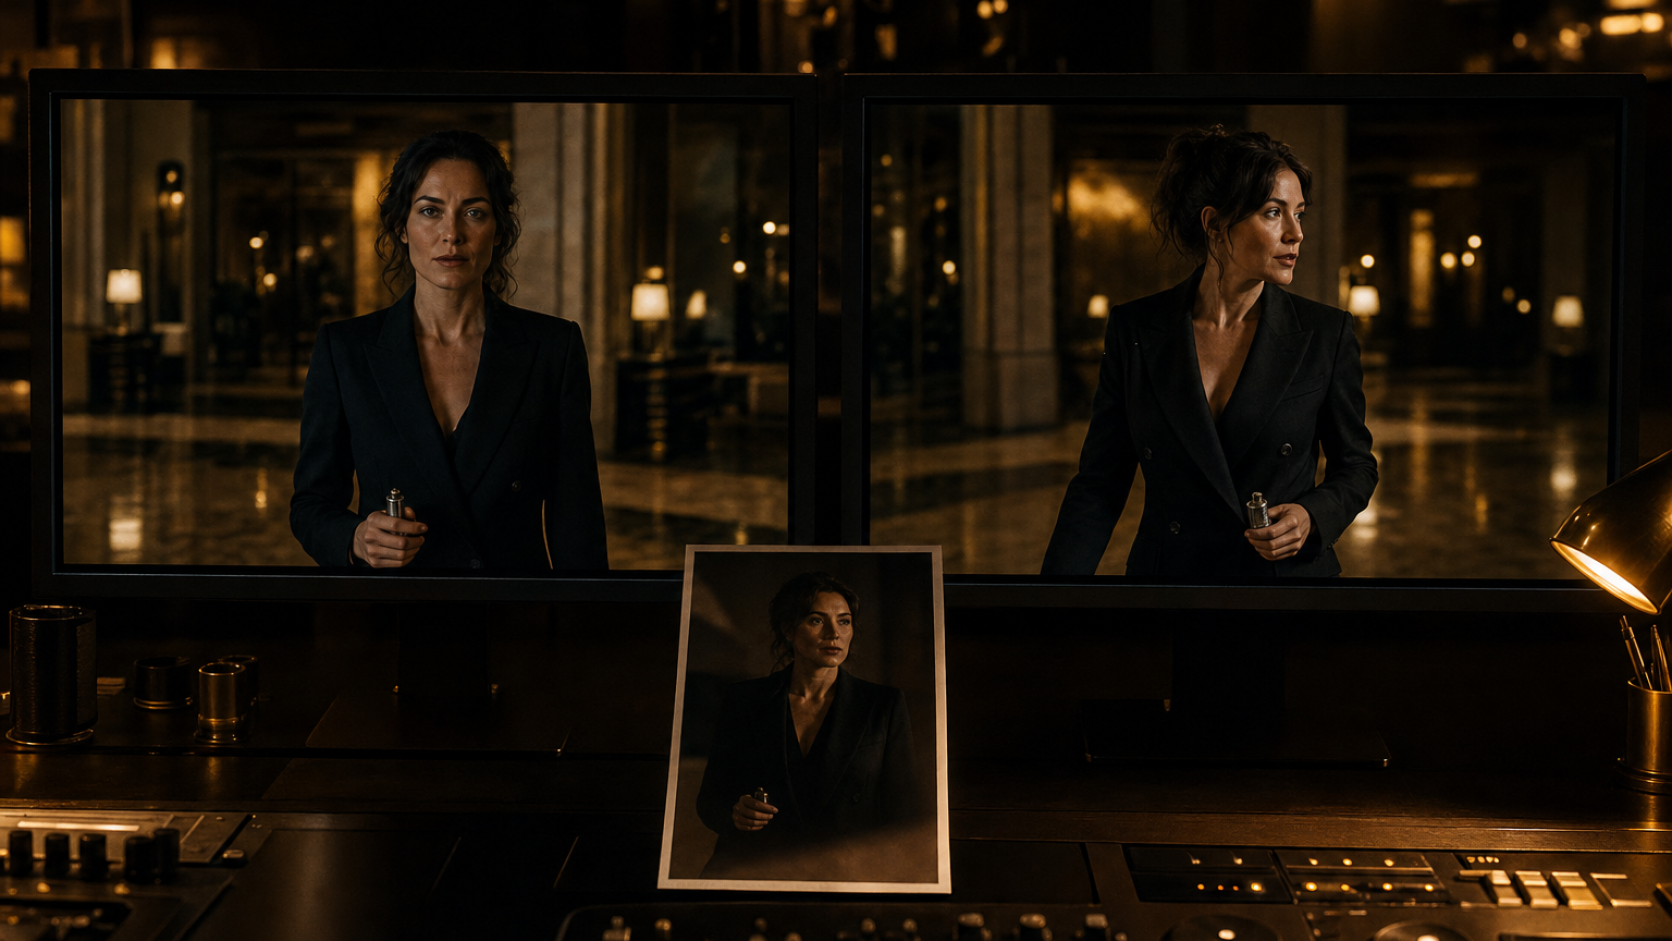
Den Einstieg bilden zwei unmittelbar aufeinanderfolgende KI-Szenen. In beiden soll dieselbe Person auftreten, doch mit dem Schnitt wirken Augenabstand und Gesichtsform plötzlich verändert, die Frisur sitzt anders oder die Jacke scheint ausgetauscht. Jede Abweichung für sich ist klein. Zusammen zerreißen sie jedoch die Illusion einer fortlaufenden Geschichte.
2. Konsistenz innerhalb und zwischen Clips
Dabei gilt es, drei Formen der Kontinuität zu unterscheiden:
Temporale Konsistenz: Bleibt eine Figur innerhalb eines Clips stabil?
Szenenübergreifende Identität: Sieht sie nach einem Schnitt weiterhin wie dieselbe Person aus?
Weltkontinuität: Bleiben Kleidung, Gegenstände, Räume und räumliche Beziehungen stimmig?
Die erste Aufgabe kann ein Modell inzwischen gut bewältigen – und an den beiden anderen dennoch scheitern. Ein Clip mag in sich geschlossen wirken; am Schnitt wird das visuelle Gedächtnis des Modells auf die Probe gestellt.
3. Referenzen werden zur digitalen Rollenakte
Um dieses Gedächtnis zu stützen, stehen mehrere neue Produktionsmittel bereit:
ein verbindliches Hauptporträt,
zusätzliche Profil- und Ganzkörperansichten,
festgelegte Kleidung und Requisiten,
Start- und Endbilder,
Referenzvideos für Bewegung und Perspektive,
wiederverwendete Figuren- und Szenenbeschreibungen.
Runway hatte diesen Ansatz bereits mit Gen-4 als „World Consistency“ positioniert: Eine einzelne Referenz sollte Figuren, Gegenstände und Orte unter verschiedenen Lichtverhältnissen und aus unterschiedlichen Perspektiven reproduzierbar machen. Damit bildet Runways Ansatz die Vorgeschichte dieses Wettbewerbs, nicht aber dessen aktuellen Nachrichtenanlass. Recherchequelle: runwayml.com
4. Googles bemerkenswerte Einschränkung
Den aktuellsten Beleg liefert Googles Hinweis vom 30. Juni. Ausgerechnet bei Szenenwechseln und Kameraschwenks – also an den Nahtstellen filmischen Erzählens – blieb die Figurenkonsistenz begrenzt.
Darin liegt der zentrale Widerspruch: Ein Modell kann spektakuläre Bilder generieren, stößt aber weiterhin an Grenzen, sobald eine gewöhnliche Anschlussaufnahme gefragt ist. Das große visuelle Versprechen scheitert vorerst an einem kleinen Blick zur Seite.
5. Aus Prompting wird Kontinuitätsregie
Längere KI-Filme beleben eine vertraute Arbeitsrolle neu. Denn jemand muss den roten Faden nicht nur in der Handlung, sondern auch im Bild bewahren:
Ist es noch dasselbe Gesicht?
Stimmt die Kleidung?
Befindet sich die Requisite noch in derselben Hand?
Passt die Blick- und Bewegungsrichtung?
Haben sich Raum, Tageszeit oder Beleuchtung unbeabsichtigt verändert?
Ausgerechnet eine klassische Aufgabe der Filmproduktion kehrt damit zurück: die Script Supervision, auch Continuity Supervision genannt.
Praktischer Test für den Artikel
Für einen eigenen Vergleich wäre eine fiktive Figur in vier Einstellungen besonders aussagekräftig:
1. Frontalaufnahme bei Tageslicht
2. Profilaufnahme bei künstlichem Licht
3. Ganzkörperaufnahme von hinten
4. Neue Umgebung mit derselben Kleidung und einem wiederkehrenden Gegenstand
Drei Verfahren ließen sich miteinander vergleichen:
ausschließlich Textbeschreibung,
ein Referenzbild,
mehrere Referenzansichten.
Als Kriterien dienen Gesicht, Körperbau, Haare, Kleidung, Requisite und Schauplatz. So wird aus einer abstrakten Produktmeldung ein journalistischer Test, bei dem die Unterschiede von Einstellung zu Einstellung sichtbar werden.
Empfehlung
Innerhalb des vorgegebenen Schwerpunkts war dieses Thema am 1. Juli 2026 die stärkste Wahl. Der Google-Start vom Vortag lieferte den aktuellen Nachrichtenanlass. Zugleich benannte Google die zentrale Schwäche offen, während Alibaba kurz zuvor eine konkurrierende technische Lösung präsentiert hatte.
Die zugespitzte Kernfrage lautet:
Wenn ein Videomodell eine Figur nach jedem Schnitt neu rekonstruieren muss, kann es dann überhaupt schon längere Geschichten erzählen – oder erzeugt es weiterhin nur überzeugende Einzelmomente?
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
Basic Tutorials – Nano Banana 2 Lite und Gemini Omni Flash: Googles neue KI-Modelle für Bild und Video
Der Fachbeitrag dokumentiert den API-Start am 30. Juni 2026 und Googles Hinweis auf Konsistenzprobleme bei Szenenwechseln und Kameraschwenks.
https://basic-tutorials.de/news/nano-banana-2-lite-gemini-omni-flash/
Molyin – HappyHorse-Guide
Der Praxisleitfaden zeigt, wie bis zu neun Referenzbilder Figuren, Kleidung, Requisiten und visuelle Stile für neue Szenen festlegen.
https://molyin.com/de/guide/happyhorse
Bundesverband Regie – Script Supervisor
Das Berufsbild erläutert die manuelle Kontrolle von Bewegungen, Blickwinkeln, Achsen, Kostümen und Requisiten für konsistente Anschlüsse.
https://www.regieverband.de/berufsbild/script-supervisor