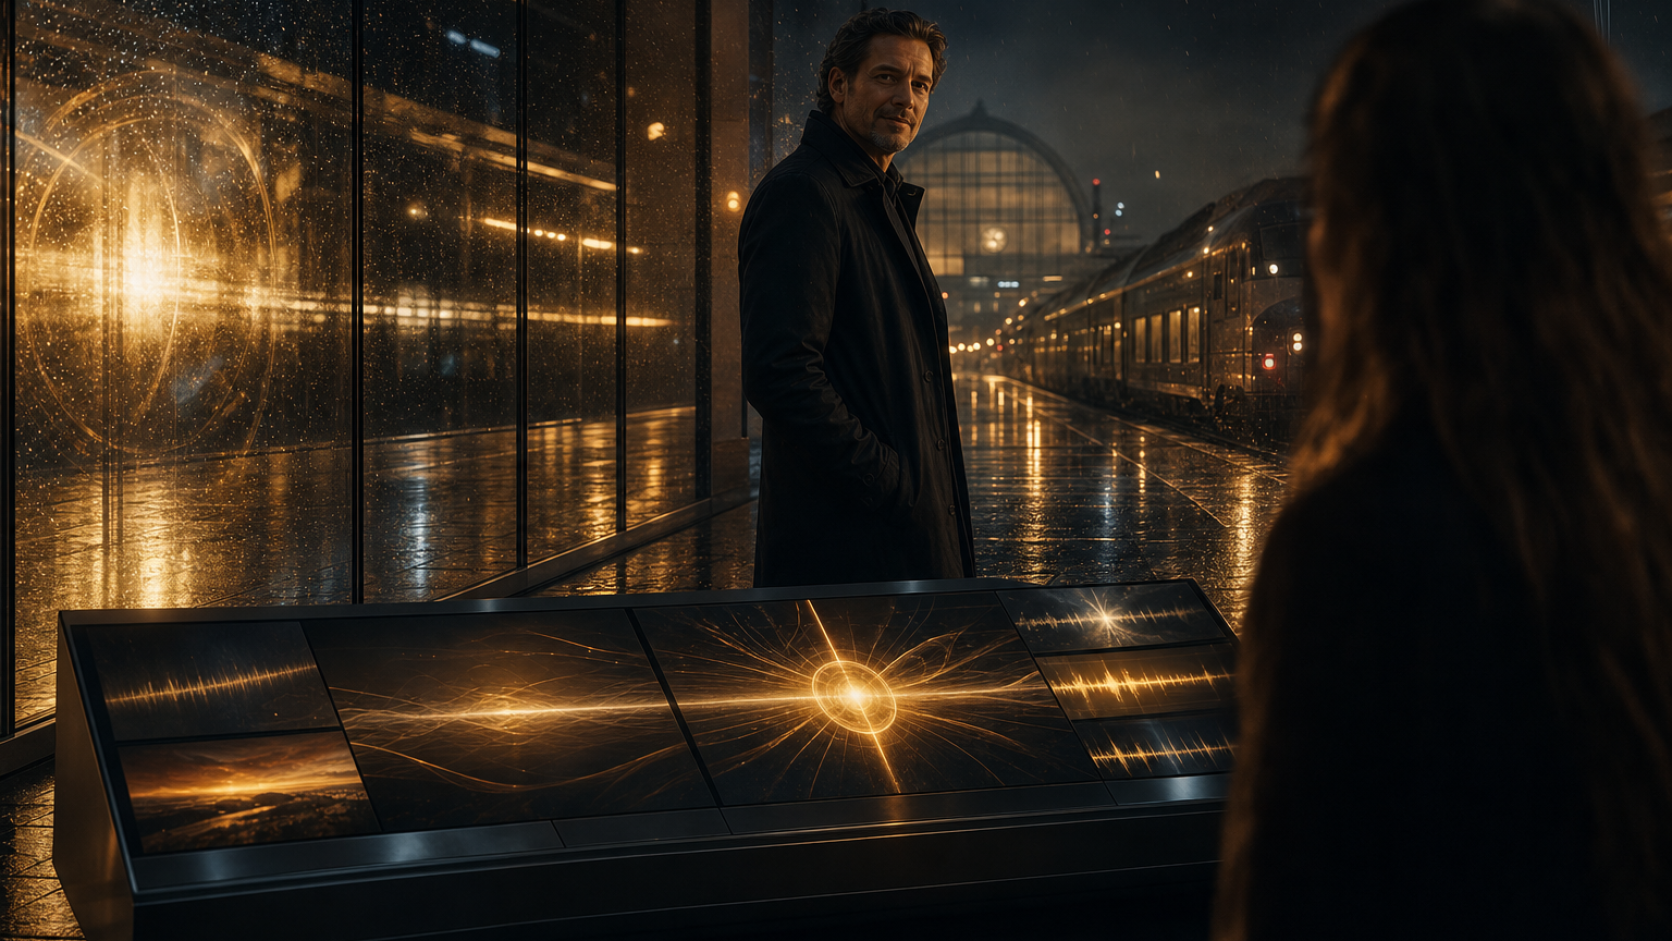
Ein Mann betritt einen Bahnhof.
Regen rinnt über die Scheiben. Seine Schritte hallen über den Boden. Eine Lautsprecherstimme kündigt einen Zug an. Im Hintergrund setzt leise Musik ein. Die Kamera fährt näher an sein Gesicht heran.
„Du bist gekommen“, sagt eine Frau außerhalb des Bildes.
Er lächelt.
Keine Kamera hat diese Szene aufgenommen. Kein Schauspieler stand im Bahnhof. Kein Tonmeister zeichnete die Schritte auf. Niemand spielte die Musik ein.
Vielleicht wird sich die gesamte Sequenz eines Tages allein auf Grundlage einer einzigen Beschreibung erzeugen lassen.
Am 12. August 2026 ist diese Vorstellung längst keine reine Science-Fiction mehr. Aktuelle Videomodelle vereinen bereits mehrere Fähigkeiten, die bisher voneinander getrennt waren: Bewegtbild, Charakterreferenzen, Szenenverlängerung und zunehmend auch synchron erzeugtes Audio. Google beschreibt sein aktuelles Veo-Modell ausdrücklich als Videogenerator, der Audio erzeugen, sich über Referenzbilder steuern und Szenen verlängern kann.
Forschungsprojekte gehen noch weiter und untersuchen die automatisierte Filmproduktion, bei der Handlung, Figuren, Bild, Dialog, Musik und Synchronisation aufeinander abgestimmt werden.
Was geschieht, wenn all diese Bausteine zu einem einzigen System verschmelzen?
1. Heute entsteht ein KI-Film noch mithilfe vieler Systeme
Wer einen längeren oder komplexeren KI-Film produziert, arbeitet meist mit einer ganzen Kette von Werkzeugen.
Ein Sprachmodell entwickelt Ideen oder Dialoge. Ein Bildgenerator erstellt Figuren und Referenzbilder. Ein Videomodell animiert die Szenen. Ein Sprachsystem erzeugt Stimmen. Ein weiteres Werkzeug komponiert die Musik.
Anschließend werden die Ergebnisse geschnitten und synchronisiert.
Das funktioniert, ist aber aufwendig.
Jedes System kennt nur einen Teil der Geschichte.
Der Bildgenerator weiß vielleicht nicht, wie eine Figur in der nächsten Dialogszene reagieren soll. Der Stimmgenerator kennt ihre Körperbewegungen nicht. Und das Musiksystem erkennt nicht automatisch, wann die Stimmung in einem Blick kippt.
Der Mensch muss diese Welten zusammenführen.
Ein multimodales System dagegen könnte den gesamten Zusammenhang erfassen. Es wüsste nicht nur, wie eine Szene aussieht. Es wüsste auch, was darin geschieht.
2. Der Prompt könnte zum Drehbuch werden
Stellen wir uns vor, eine zukünftige Film-KI erhält nicht nur die Beschreibung eines Bildes, sondern eine vollständige Szene:
Zwei alte Freunde treffen sich nach zwanzig Jahren auf einem verlassenen Bahnhof. Die Stimmung ist zunächst angespannt. Nach dem ersten Satz erkennt einer von ihnen, dass der andere ihm vergeben hat. Die Kamera soll langsam näher kommen. Der Regen wird leiser. Die Musik setzt erst nach der Versöhnung ein.
Heute müsste ein Kreativer daraus zahlreiche einzelne Produktionsanweisungen entwickeln.
Ein integriertes System könnte die Szene selbstständig in einzelne Einstellungen auflösen.
Totale. Halbnahe Einstellung. Nahaufnahme. Dialog. Blickrichtung. Geräuschkulisse. Musikalischer Einsatz.
So würde sich der Prompt von einer visuellen Beschreibung zu etwas entwickeln, das eher einem Drehbuch oder einer Regieanweisung gleicht.
Der Mensch sagt dann nicht mehr nur, was zu sehen sein soll. Er beschreibt, was die Szene bedeuten soll.
3. Konsistenz bleibt der Schlüssel zum langen Film
Die größte Herausforderung ist allerdings nicht die einzelne perfekte Szene. Sie liegt im Gedächtnis.
Ein Film muss wissen, dass der Mann aus Minute zwei derselbe Mensch ist wie in Minute achtundvierzig.
Seine Stimme muss gleich bleiben. Seine Kleidung muss zum bisherigen Verlauf der Geschichte passen. Eine Verletzung, die er in einer früheren Szene erleidet, darf später nicht einfach verschwinden.
Dasselbe gilt für Orte, Gegenstände und Beziehungen.
Die aktuelle Forschung widmet dieser langfristigen Konsistenz deshalb besondere Aufmerksamkeit. CineAGI beispielsweise arbeitet mit hierarchischer Planung, Charakterverwaltung und der Synchronisierung mehrerer audiovisueller Elemente über verschiedene Szenen hinweg.
Andere Forschungsarbeiten verfolgen den Ansatz, Figuren mithilfe stabiler visueller Anker über längere Sequenzen hinweg konsistent zu halten.
Der Weg zum KI-Spielfilm führt also nicht nur über bessere Bilder. Er führt auch über ein verlässliches Gedächtnis.
4. Ein Film könnte für jeden Zuschauer anders werden
Sobald eine KI nicht mehr nur einzelne Clips erzeugt, sondern die Handlung versteht, eröffnet sich eine noch radikalere Möglichkeit.
Personalisierte Filme.
Eine Geschichte könnte ihre Sprache automatisch wechseln. Nebenfiguren könnten an unterschiedliche kulturelle Kontexte angepasst werden. Ein Kinderfilm könnte die Länge einzelner Szenen auf das Alter des Zuschauers abstimmen.
Noch weiter gedacht könnte eine Geschichte sogar während des Betrachtens neue Wege einschlagen.
Der Zuschauer entscheidet, ob die Hauptfigur eine Tür öffnet.
Die KI erzeugt dann nicht nur eine zuvor gespeicherte Alternative, sondern führt die Handlung neu fort.
Damit würde der Film ein Stück weit die Grenze zum Computerspiel überschreiten. Anders als in einem klassischen Spiel müssten jedoch nicht sämtliche Varianten im Voraus produziert werden.
Die Geschichte könnte während des Betrachtens entstehen. Jede Vorführung würde ein wenig anders verlaufen.
Ein Film hätte dann nicht mehr nur ein Ende. Er hätte viele mögliche Verläufe.
5. Je mehr automatisiert wird, desto wichtiger wird die menschliche Idee
Diese Entwicklung klingt zunächst nach einer vollständigen Automatisierung der Filmproduktion.
Doch genau hier entsteht ein Paradox.
Je leichter sich Bilder, Stimmen und Musik erzeugen lassen, desto weniger wertvoll wird ihre bloße Herstellung.
Wenn jeder auf Knopfdruck einen Sonnenuntergang produzieren kann, beeindruckt der Sonnenuntergang allein nicht mehr.
Wenn jede KI eine dramatische Musikspur komponieren kann, ist nicht mehr entscheidend, dass überhaupt Musik vorhanden ist. Entscheidend ist der Moment, in dem sie beginnt.
Die Knappheit technischer Möglichkeiten wird durch die Knappheit guter Ideen ersetzt.
Gute Ideen bleiben selten. Gute Figuren zu entwickeln, bleibt schwierig.
Eine Geschichte, die Menschen zwei Stunden lang nicht loslässt, entsteht nicht automatisch dadurch, dass jedes einzelne Bild perfekt aussieht.
Aktuelle Produktionsplattformen machen diese Verschiebung bereits sichtbar: Mit zunehmender Reife der Modelle verlagert sich die Arbeit vom bloßen Beherrschen einzelner Werkzeuge hin zu Entscheidungen über Tonalität, Struktur und Bedeutung.
Vielleicht wird der Film der Zukunft deshalb tatsächlich von einer einzigen KI erzeugt.
Bild, Stimme, Musik, Dialog und Geräusche stammen dann aus demselben System.
Doch am Anfang dieses Prozesses steht weiterhin ein Mensch.
Er beschreibt eine Figur, die noch niemand kennt. Er entscheidet, dass es regnen soll. Er streicht einen Satz, weil Schweigen stärker wirkt. Er lässt die Musik fünf Sekunden später beginnen.
Und plötzlich ist aus Milliarden errechneter Möglichkeiten eine Geschichte geworden.
Die Maschine kann künftig vielleicht einen ganzen Film erzeugen.
Doch die wichtigste Frage bleibt seit den ersten Geschichten am Feuer dieselbe:
Was wollen wir erzählen?
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
Google Flow-Hilfe – Informationen zu Google Flow-Modellen und unterstützten Funktionen
Die aktuelle Funktionsübersicht konkretisiert, welche Veo-3.1-Varianten Referenzbilder, Audioreferenzen und die Verlängerung bestehender Videoclips unterstützen.
https://support.google.com/flow/answer/16352836?hl=de
arXiv – CineAGI: Character-Consistent Movie Creation through LLM-Orchestrated Multi-Modal Generation and Cross-Scene Integration
Die Forschungsarbeit vertieft die im Artikel beschriebene automatisierte Filmproduktion durch hierarchische Planung, Charakterverwaltung und szenenübergreifende audiovisuelle Synchronisation.
https://arxiv.org/abs/2604.23579
Gloria-Forschungsteam – Gloria: Consistent Character Video Generation via Content Anchors
Die Projektseite erläutert, wie globale, perspektivische und ausdrucksbezogene Anker die Identität einer Figur über lange Videosequenzen stabil halten sollen.
https://yyvhang.github.io/Gloria_Page/