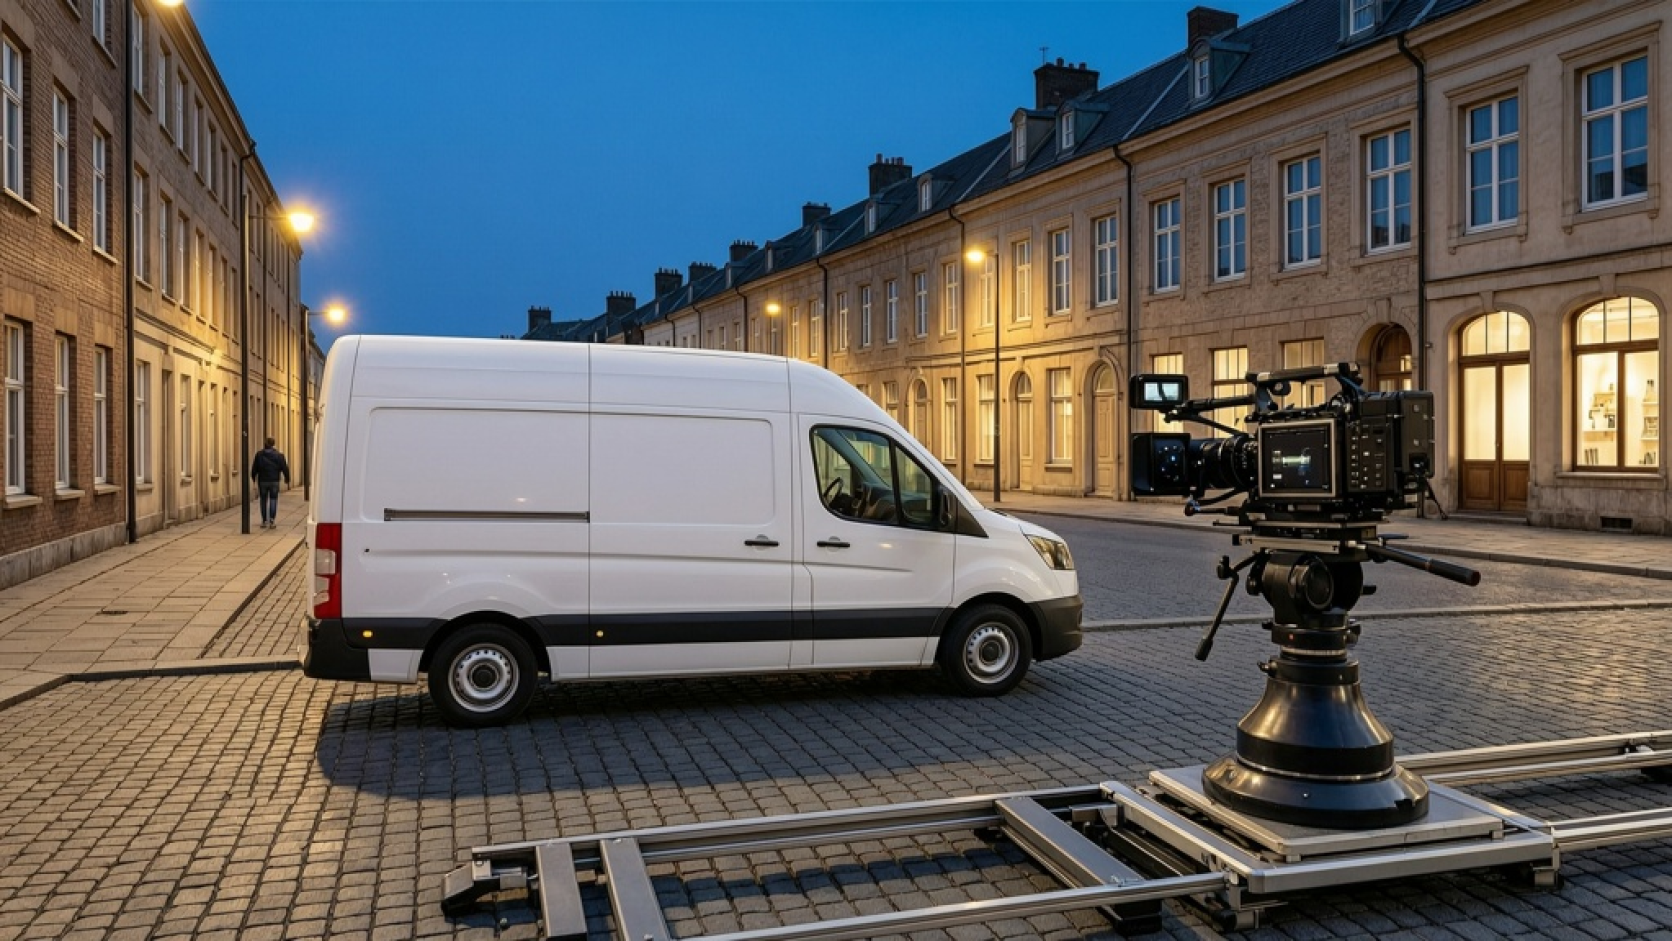
Ein weißer Lieferwagen fährt nach links aus dem Bild, während sich die Kamera nach rechts bewegt. Ein Mensch kann sich diese Szene mühelos vorstellen. Für ein KI-Videomodell entfesselt die knappe Anweisung jedoch ein kleines geometrisches Gewitter: Welche Pixel gehören zum Wagen, welche zur Straße? Welche Flächen werden durch die gegenläufige Kamerafahrt erstmals sichtbar? Und wer sorgt dafür, dass hinter dem Fahrzeug tatsächlich eine plausible Häuserzeile auftaucht – statt einer weich zerfließenden Ersatzwelt?
Getrennte Wege für Kamera und Motiv
Hier setzt UniCaMo an, ein am 2. Juli 2026 veröffentlichtes Forschungsprojekt von Qualcomm AI Research. Das Verfahren soll Objektbewegungen und Kamerafahrten gemeinsam kontrollieren, ohne beides miteinander zu vermischen. Eine Szene behandeln die Forscher nicht mehr bloß als Folge zweidimensionaler Bilder, sondern als räumlichen Zusammenhang, in dem Motiv und Kamera eigene Wege nehmen können. Recherchequelle: arxiv.org
Was nach einem Spezialproblem für Computergrafiker klingt, berührt eine der wichtigsten Fragen der KI-Videogenerierung: Was heißt es überhaupt, eine Maschine Regie führen zu lassen?
Der Prompt wird zum digitalen Filmset
Bei heutigen Videogeneratoren wird längst nicht mehr nur beschrieben, was im Bild erscheinen soll. Zunehmend enthält der Prompt auch Vorgaben zu Bildausschnitt, Blickwinkel, Kamerabewegung und Bildwirkung. Google empfiehlt für Veo ausdrücklich Angaben wie Nahaufnahme, niedriger Kamerawinkel oder Schwenk. Je detaillierter die Beschreibung ausfällt, desto größer soll die Kontrolle über das Ergebnis sein. Recherchequelle: deepmind.google
So wird der Prompt zum digitalen Set. „Langsame Kamerafahrt auf das Gesicht zu, geringe Schärfentiefe, 35-Millimeter-Look“ klingt bereits wie eine Anweisung an Kamera und Objektiv. Nur besitzt das Modell weder das eine noch das andere. Es berechnet Bildfolgen, die wirken sollen, als wären diese Werkzeuge tatsächlich zum Einsatz gekommen.
Doch die filmische Ähnlichkeit täuscht. Sowohl ein Zoom als auch eine Kamerafahrt können ein Gesicht im Bild größer werden lassen – und doch sind beide grundverschieden. Beim Zoom verändert sich die Brennweite; die Kamera bleibt stehen, und die räumliche Perspektive bleibt weitgehend erhalten. Bei einer Dollyfahrt hingegen bewegt sie sich tatsächlich auf die Person zu. Vorder- und Hintergrund verschieben sich unterschiedlich stark gegeneinander, Parallaxe entsteht. Der Raum beginnt zu atmen.
Noch verwickelter wird es, sobald sich auch die Person bewegt. Läuft sie auf die Kamera zu? Folgt die Kamera ihr? Warum verschiebt sich der Hintergrund – wegen einer echten Fahrt, eines Schwenks oder einer Veränderung des Bildwinkels? Das Videomodell muss diese Vorgänge auseinanderhalten, obwohl es am Ende nur eine Folge farbiger Flächen erzeugt.
In seiner technischen Anleitung unterscheidet Google deshalb sehr genau zwischen Schwenk, Neigung, seitlicher Fahrt, Dollybewegung, Zoom, Kranfahrt und kreisförmiger Bewegung um ein Motiv. Hinzu kommen Weitwinkel, Telewirkung, Fokusverlagerung und der sogenannte Vertigo-Effekt als eigenständige Gestaltungsmittel. Bei Letzterem fährt die Kamera in eine Richtung, während das Objektiv gleichzeitig in die entgegengesetzte Richtung zoomt. Das Motiv behält ungefähr seine Größe, doch der Hintergrund scheint sich dramatisch zu dehnen oder zusammenzuschieben. Recherchequelle: Google Cloud Documentation
Wie UniCaMo Bewegung im Raum verankert
Filmische Begriffe lassen sich leicht in einen Prompt schreiben. Ihre räumlichen Folgen korrekt zu berechnen, ist erheblich schwieriger. UniCaMo setzt deshalb früher an: Die gewünschte Bewegung wird bereits im Ausgangsrauschen angelegt – jenem zunächst chaotischen Zahlenfeld, aus dem ein Diffusionsmodell Schritt für Schritt das Video herausarbeitet.
Für bewegte Objekte nutzt das System räumliche Punktbahnen. Vereinfacht gesagt werden markante Punkte eines Gegenstands durch den dreidimensionalen Raum geführt. Soll eine Frau hinter einer anderen Person vorbeigehen, erhält das Modell nicht nur eine Linie auf dem flachen Bild, sondern auch Informationen über Tiefe und Sichtbarkeit. So kann es besser bestimmen, wann die Frau verdeckt wird und an welcher Stelle sie wieder auftauchen muss.
Auch die Kamera erhält eine eigene Bahn. Damit Bildbereiche, die während der Bewegung neu ins Sichtfeld geraten, konsistent entstehen, platzieren die Forscher die virtuelle Kamera innerhalb einer großen Kugel. Auf ihrer Oberfläche liegt ein gleichmäßig verteiltes Rauschmuster. Richtet sich die Kamera während ihrer Fahrt neu aus, greift das System auf den passenden Bereich derselben Kugel zurück. Die Rauschmuster der Einzelbilder bleiben dadurch räumlich miteinander verknüpft, statt bei jedem Bild gewissermaßen von vorn zu beginnen.
Eine detailgetreue Rekonstruktion der Szene ist diese Kugel nicht. Sie bildet eher ein unsichtbares Gerüst, an dem sich die Generierung orientieren kann. „Track the Noise“ nennen die Forscher die Führung der Objektpunkte, „Move the World“ die Stabilisierung der Umgebung bei wechselnden Kameraperspektiven. Anschließend fließen beide Teile in ein gemeinsames Ausgangsrauschen ein. Die Projektseite zeigt Beispiele für reine Objektbewegungen, isolierte Kamerafahrten und kombinierte Abläufe. Recherchequelle: phongnhhn.info
Gute Testwerte, aber noch kein Regieknopf
In den eigenen Vergleichstests auf dem MoveBench-Datensatz schnitt UniCaMo bei der Bildqualität und der Genauigkeit der vorgegebenen Bewegungsbahnen besser ab als die untersuchten Konkurrenzverfahren. Besonders deutlich zeigen sich die Unterschiede in Szenen, in denen sich Motiv und Kamera bewusst gegenläufig bewegen. Frühere Ansätze ließen dort laut den Autoren Fahrzeuge in die falsche Richtung fahren, verformten einzelne Bildteile oder hielten die gewünschte Bewegung nicht ein. Im Einzelobjekt-Test erzielte UniCaMo unter anderem einen niedrigeren Trajektorienfehler als Wan-Move. Allerdings stammen diese Werte aus der Veröffentlichung des Entwicklerteams. Dass UniCaMo im Produktionsalltag generell überlegen ist, belegen sie noch nicht.
Auch der technische Aufwand erinnert daran, dass hier kein fertiger Regieknopf vorgestellt wurde. Das Modell basiert auf Wan 2.1 mit 14 Milliarden Parametern und wurde mit 400.000 Videoclips weitertrainiert. Dafür kamen 32 H100-Grafikprozessoren drei Tage lang zum Einsatz. Bei der anschließenden Generierung benötigt die Bewegungssteuerung nach Angaben der Forscher keine zusätzlichen Modellmodule. Das Verformen des Ausgangsrauschens verursacht ungefähr 0,2 Sekunden Mehraufwand pro Beispiel.
Vor allem aber ist UniCaMo noch keine reine Textregie. Die Nutzer müssen Objekte markieren und sowohl deren räumliche Bahnen als auch die Kamerafahrt in einer grafischen 3D-Ansicht festlegen. Der Prompt beschreibt weiterhin Inhalt und Erscheinungsbild; die genaue Bewegung wird jedoch geometrisch vorgegeben. Einen Teil des Problems löst das Verfahren also, indem es die Arbeit nicht allein der Sprache überlässt.
Wenn KI Zoom und Dolly verwechselt
Wie schwer diese Trennung selbst für andere KI-Systeme ist, zeigte eine weitere Forschungsarbeit, die am 3. Juli 2026 erschien. Untersucht wurde darin, wie zuverlässig Bild-Sprach-Modelle Kamerabewegungen erkennen und mit filmischen Begriffen benennen. Die Systeme verwechselten unter anderem Links und Rechts, Schwenk und seitliche Fahrt sowie Objektbewegung und Kamerabewegung. Selbst einen optischen Zoom und eine tatsächliche Dollyfahrt konnten sie häufig nicht zuverlässig auseinanderhalten. Ein speziell trainiertes Modell verbesserte die Ergebnisse, blieb aber deutlich hinter Menschen zurück. Recherchequelle: arxiv.org
Die künftige Regie spricht zwei Sprachen
Allmählich zeichnet sich damit eine Arbeitsteilung für künftige KI-Filmwerkzeuge ab. Die Sprache formuliert die Absicht: langsam auf das Gesicht zufahren, den Raum enger wirken lassen, eine Figur umrunden, den Hintergrund mit langer Brennweite verdichten. Eine geometrische Ebene übersetzt diese Absicht in Kamerapositionen, Blickrichtungen, Brennweiten und Bewegungsbahnen. Erst danach erzeugt das Videomodell die sichtbare Szene.
Google bewirbt Flow bereits als Werkzeug, das direkte Kontrolle über Kamerabewegungen, Winkel und Perspektiven bieten soll. Aus einer Beschreibung soll eine inszenierte Aufnahme werden, nicht bloß ein bewegtes Bild. Recherchequelle: blog.google
UniCaMo macht sichtbar, wie viel Technik zwischen einer Beschreibung und der fertigen Aufnahme liegt. Eine Maschine kann das Wort „Kamerafahrt“ verwenden und trotzdem den Raum missverstehen. Echte Regie beginnt dort, wo sie weiß, was sich bewegt – das Motiv, das Objektiv oder der Blick selbst.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
Qualcomm AI Research – Track the Noise, Move the World: 3D-basierte bewegungskonsistente Rauschsteuerung für die kontrollierbare Videogenerierung
Die Projektseite erklärt UniCaMos Zusammenspiel aus räumlichen Punktbahnen, „Track the Noise“, „Move the World“ und kugelförmigem Rauschmuster anhand technischer Grafiken und Videobeispiele.
https://phongnhhn-info.translate.goog/Unicamo/?_x_tr_sl=en&_x_tr_tl=de&_x_tr_hl=de
alphaXiv – Track the Noise, Move the World: UniCaMo auf MoveBench
Die Übersicht stellt UniCaMos FID-, FVD- und EPE-Ergebnisse den Werten von Wan-Move und weiteren Verfahren gegenüber, wobei die Tests als entwicklereigene und nicht unabhängig validierte Vergleiche einzuordnen sind.
https://www-alphaxiv-org.translate.goog/abs/2607.02798?_x_tr_sl=en&_x_tr_tl=de&_x_tr_hl=de
alphaXiv – Natursprachliches Kamerabewegungsverständnis
Die Forschungsübersicht erläutert am ACaM-Benchmark typische Verwechslungen zwischen Schwenk, Fahrt, Dolly, Zoom und Objektbewegung sowie den deutlichen Leistungsabstand zu Menschen.
https://www.alphaxiv.org/de/abs/2607.03043