Ein fertiger Song wirkt wie ein einziges Klangbild. Die Stimme liegt zwischen Gitarren, Bass und Schlagzeug, Hall zieht durch den Raum, einzelne Töne berühren sich und verschwinden wieder. Alles scheint miteinander verwoben.
Früher war diese Mischung nahezu unumkehrbar. Wer allein den Gesang aus einer fertigen Stereoaufnahme entfernen wollte, erhielt häufig ein Ergebnis voller Artefakte. Von der Stimme blieben Schatten zurück, Instrumente klangen hohl, und aus der Musik wurde ein akustisches Puzzle, dem Teile fehlten.
Künstliche Intelligenz hat diese Grenze inzwischen weit verschoben.
Wie konkret diese Entwicklung geworden ist, zeigte sich am 5. August 2026 auch bei neuen und aktualisierten Audiowerkzeugen. Mehrere Plattformen warben mit KI-gestützter Stem-Separation und der Möglichkeit, einzelne Bestandteile eines Titels gezielt weiterzubearbeiten. SoundBoost integrierte beispielsweise Anweisungen zur gezielten Bearbeitung einzelner Stems in seinen Mastering-Workflow.
Wie KI einen fertigen Mix zerlegt
Doch was geschieht eigentlich, wenn eine KI einen fertigen Song wieder in seine Bestandteile zerlegt?
Ein klassischer Musikmix lässt sich mit einem gebackenen Kuchen vergleichen. Mehl, Zucker, Butter und Eier sind vorher noch klar voneinander zu unterscheiden. Nach dem Backen bilden sie ein neues Ganzes. Niemand kann anschließend einfach das Ei wieder herausnehmen.
Mit einer fertigen Stereoaufnahme verhielt es sich lange ganz ähnlich.
Gesang, Bass, Schlagzeug, Klavier und Gitarren werden zu einem gemeinsamen Mix zusammengeführt. Die ursprünglichen Einzel- und Gruppenspuren, häufig als Stems bezeichnet, existieren möglicherweise noch im Studio, nicht aber in der veröffentlichten Datei.
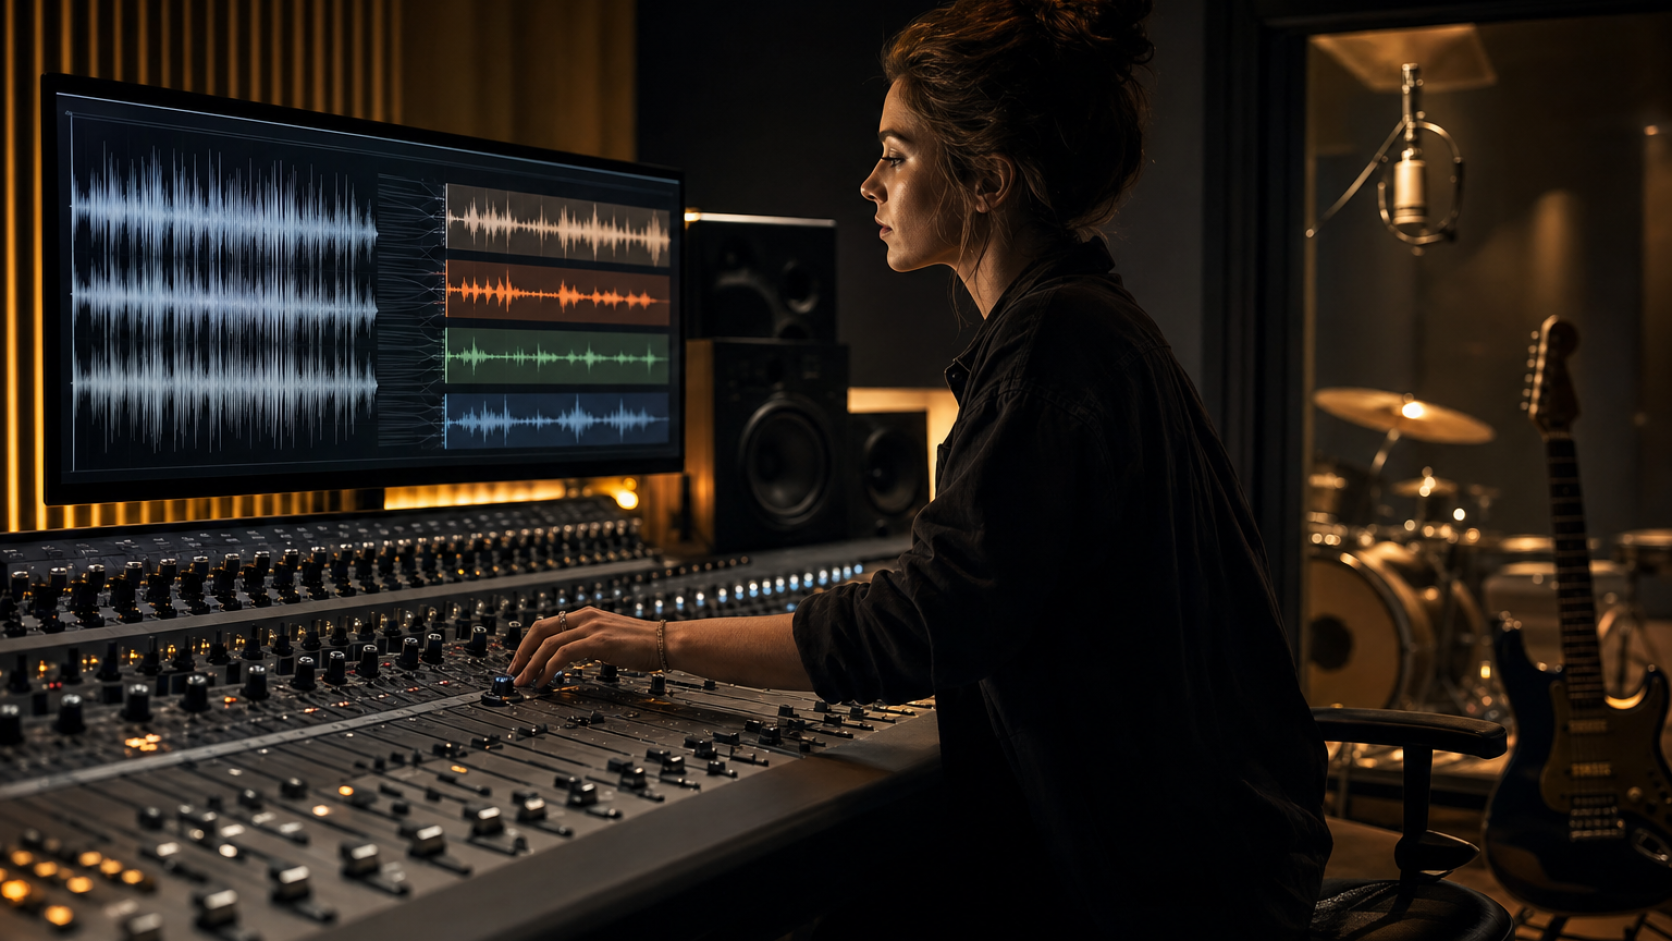
Eine KI versucht nun, diesen Prozess zumindest teilweise umzukehren. Sie analysiert das Frequenzspektrum, zeitliche Strukturen und typische Klangmuster. Eine Stimme verhält sich anders als eine Bassdrum. Ein Becken weist andere spektrale Eigenschaften auf als eine Bassgitarre.
Anhand unzähliger Beispiele lernt ein Modell, solche Muster voneinander zu unterscheiden. Daraus entstehen neu rekonstruierte, voneinander getrennte Spuren.
Die ursprünglichen Studioaufnahmen entstehen dabei allerdings nicht von Neuem. Stattdessen rekonstruiert die KI möglichst plausible Fassungen der einzelnen Spuren.
Von groben Stems zur feinen Klangtrennung
Die ersten weitverbreiteten Systeme trennten Musik meist in einige wenige Hauptgruppen: Gesang, Schlagzeug, Bass und „Sonstiges“. Schon das war beeindruckend.
Heute wird diese Aufteilung immer feiner. Gitarren oder Klaviere können isoliert werden. Das Schlagzeug lässt sich teilweise noch weiter in Kick, Snare, Toms, Hi-Hat und Becken zerlegen. Sprach- und Postproduktionswerkzeuge versuchen wiederum, Dialoge aus komplexen Hintergrundgeräuschen herauszulösen.
Damit verändert sich auch unsere Vorstellung von einer fertigen Aufnahme. Ein fertiger Stereomix wird wieder formbar.
Ein Produzent kann den Gesang etwas anheben, ohne gleich das gesamte Stück lauter machen zu müssen. Ein Remix kann die Originalstimme beibehalten und mit einem völlig neuen Arrangement unterlegen. Musiker können ein Gitarrensolo isolieren, um es genauer zu analysieren.
Musik, die einst wie eine verschlossene Schachtel wirkte, lässt sich plötzlich wieder öffnen.
Neue Möglichkeiten für Restaurierung und Produktion
Besonders interessant ist Stem-Separation dort, wo die ursprünglichen Projektdateien fehlen. Vielleicht existiert von einer zwanzig Jahre alten Aufnahme nur noch ein Stereo-Master. Das damalige Studio wurde geschlossen, Festplatten sind verloren gegangen, Projektdateien lassen sich nicht mehr öffnen.
Früher bedeutete das: Der Mix bleibt so, wie er ist.
Nun können einzelne Elemente zumindest näherungsweise rekonstruiert werden. Das eröffnet neue Möglichkeiten für Remastering, Archivarbeit und Restaurierung. Eine Stimme kann gezielter bearbeitet, störende Klanganteile können reduziert oder ein Instrument kann im Mix neu ausbalanciert werden.
Auch bei neuer Musik entstehen dadurch kreative Freiheiten.
Ein Musiker kann zunächst ein eigenes Demo vollständig generieren lassen, anschließend die Stimme isolieren und durch eine selbst eingesungene Fassung ersetzen. Vielleicht bleibt nur das Schlagzeug erhalten, während Bass und Gitarren neu aufgenommen werden.
KI-Generierung und menschliche Produktion bilden dadurch keine zwei getrennten Welten mehr. Sie können ineinandergreifen.
Wo die Rekonstruktion an Grenzen stößt
So eindrucksvoll moderne Systeme auch wirken: Sie haben Grenzen.
Instrumente teilen sich Frequenzbereiche. Eine Gitarre und eine Stimme können zur selben Zeit ähnliche Bereiche des Spektrums belegen. Hall verbindet die Klänge. Verzerrte Gitarren erzeugen komplexe Obertonstrukturen. Hintergrundchöre verschmelzen mit dem Hauptgesang.
Die KI muss daher zwangsläufig schätzen.
Bei komplexen oder dicht arrangierten Aufnahmen entstehen hörbare Artefakte. Ein Becken klingt plötzlich wässrig, Reste der Stimme schimmern in einer Instrumentalspur durch, oder einzelne Transienten gehen verloren.
Je besser das Ausgangsmaterial ist und je deutlicher sich die Instrumente voneinander unterscheiden, desto überzeugender fällt die Trennung aus.
Das führt vor Augen, was die KI hier tatsächlich tut. Sie öffnet keine alte Studiotür und holt die ursprüngliche Gesangsspur heraus. Sie rekonstruiert lediglich eine mögliche Fassung dieser Spur.
Gerade bei professionellen Anwendungen bleibt kritisches Hören deshalb unverzichtbar.
Warum formbare Musik die eigentliche Revolution ist
Vielleicht ist die Generierung kompletter Songs gar nicht die spannendste Entwicklung im Bereich der KI-Musik. Vielleicht liegt sie vielmehr in der Möglichkeit, Musik wieder formbar zu machen.
Generative Systeme beeindrucken, weil sie innerhalb von Sekunden etwas Neues hervorbringen. Stem-Separation wirkt dagegen unscheinbarer. Für Produzenten könnte sie langfristig jedoch mindestens ebenso bedeutend sein.
Denn Kreativität entsteht nur selten mit dem ersten Ergebnis.
Ein Song wird verändert. Ein Refrain bekommt mehr Raum. Ein Instrument verschwindet. Eine Stimme wird ersetzt. Eine alte Aufnahme erhält plötzlich eine zweite Chance.
Aktuelle KI-Musikwerkzeuge entfernen sich deshalb zunehmend von der simplen Vorstellung eines Knopfes, der auf Druck einen fertigen Song ausgibt. Solche Systeme kombinieren Generierung mit bearbeitbaren Spuren, MIDI, Stem-Separation und klassischen Produktionswerkzeugen.
Damit rückt ausgerechnet durch künstliche Intelligenz etwas sehr Menschliches wieder in den Mittelpunkt: die Entscheidung.
Der erste Klang muss nicht der endgültige sein.
Eine Stimme kann herausgelöst werden. Ein Schlagzeugpart kann neu aufgebaut werden. Eine Melodie darf bleiben, während alles um sie herum verschwindet.
Musik wird wieder zu Material.
Und manchmal hört man einen vertrauten Song danach mit anderen Ohren, weil plötzlich sichtbar wird, wie viele kleine Welten in diesem Song verborgen waren.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
PyTorch – Music Source Separation with Hybrid Demucs
Das technische Tutorial zeigt praxisnah, wie ein Hybrid-Demucs-Modell Audiodateien in Gesang, Schlagzeug, Bass und weitere Bestandteile zerlegt.
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
Open-Source Tools & Data for Music Source Separation – Evaluation
Die Forschungsseite erläutert Qualitätsmetriken wie SDR, SIR und SAR sowie die Grenzen rein rechnerischer Bewertungen von Trennungsergebnissen.
https://source-separation.github.io/tutorial/basics/evaluation.html
The Beatles – Giles Martin Talks to Music Radar and Demonstrates the Machine Learning Technology Used in the Production of "Now And Then"
Die offizielle Beatles-Seite führt zu einem konkreten Anwendungsfall, bei dem maschinelles Lernen zur Isolation einer historischen Gesangsaufnahme eingesetzt wurde.
https://www.thebeatles.com/giles-martin-talks-music-radar-and-demonstrates-machine-learning-technology-used-production-now-and