Eine künstliche Intelligenz beginnt nicht mit Wissen. Am Anfang kennt sie keine Sprache, hat keine Vorstellung davon, wie ein Hund aussieht, kennt weder eine Melodie noch einen Sonnenuntergang und weiß nicht, dass sich eine Tür öffnen lässt oder ein Satz manchmal mehr bedeutet als die Wörter, aus denen er besteht.
All das muss ein Modell lernen. Nicht auf dieselbe Weise wie ein Kind. Nicht mit Augen, Ohren und Erinnerungen. Sondern mit Daten.
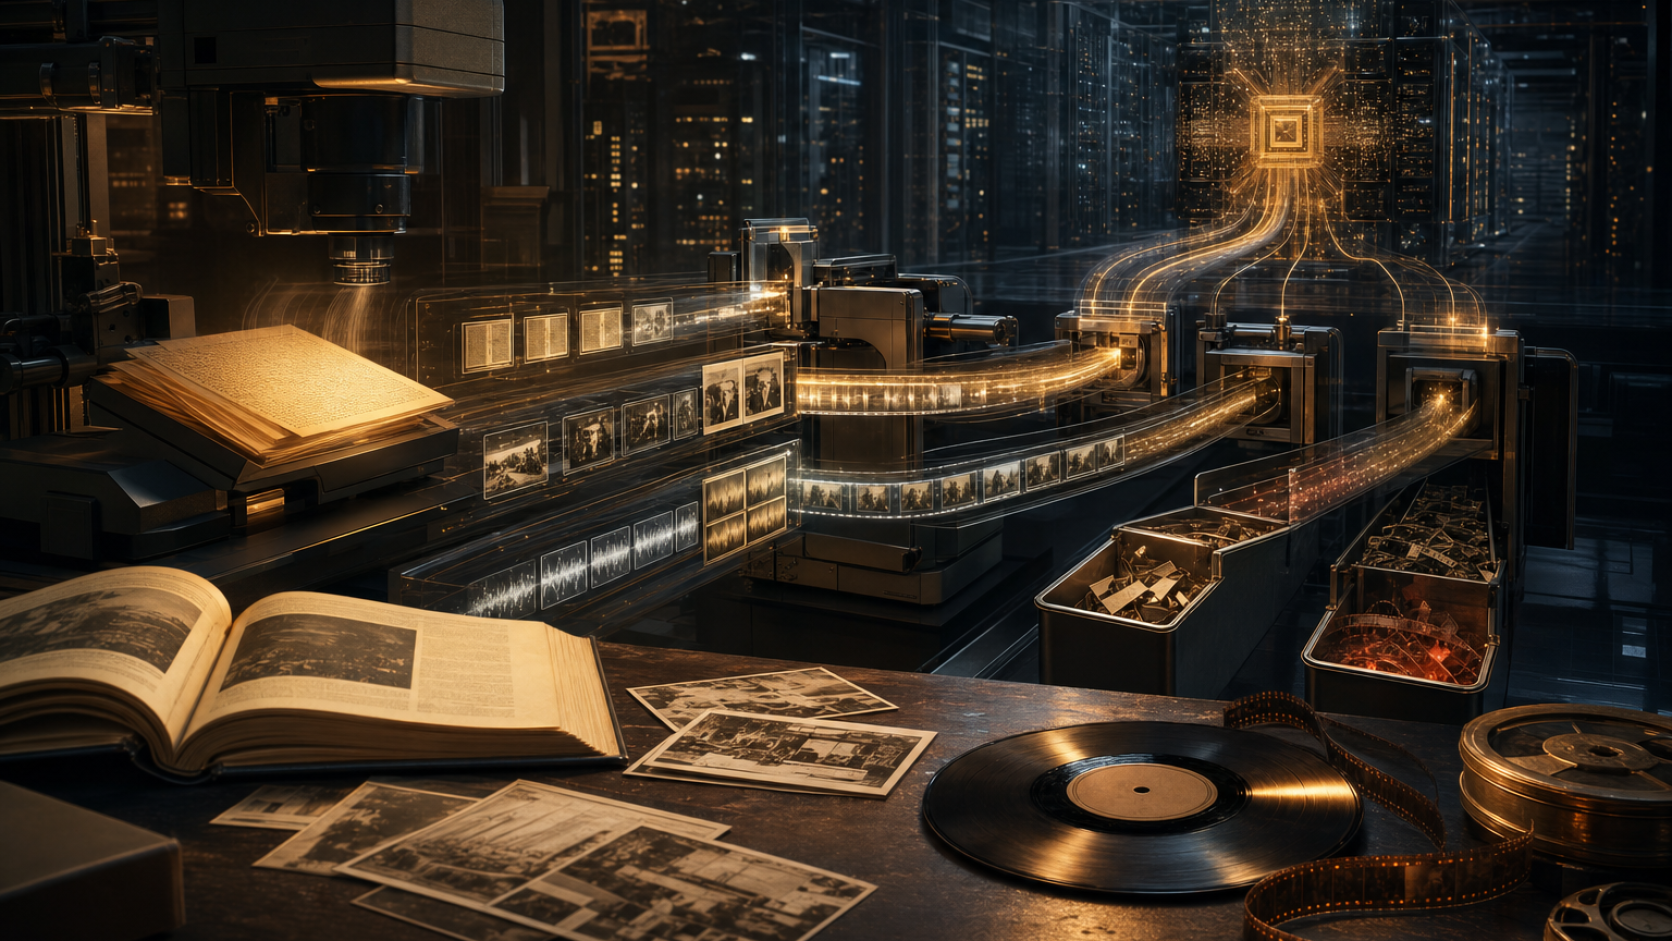
Hinter einem modernen KI-System steht deshalb etwas, das der Nutzer normalerweise nie zu sehen bekommt: eine gewaltige Verarbeitungskette. Webseiten werden durchsucht, Dateien gesammelt, Texte zerlegt, Bilder beschrieben, Audiodaten analysiert und Videos in Szenen, Sequenzen und zeitliche Abläufe zerlegt. Dubletten verschwinden, unerwünschtes Material wird herausgefiltert, Inhalte werden bewertet, gruppiert und in Formen überführt, die mathematische Modelle verarbeiten können.
Erst danach beginnt das eigentliche Training.
Wer verstehen möchte, warum Trainingsdaten heute politisch, wirtschaftlich und kulturell so umstritten sind, muss deshalb einen Schritt zurückgehen.
Die erste Frage sollte nicht lauten:
Was kann diese KI erzeugen?
Sondern:
Wie wurden menschliche Werke überhaupt zu Trainingsmaterial?
Genau hier liegt das Feld des Text-und-Data-Minings. Und hier beginnt die Geschichte hinter fast jedem großen generativen Modell.
1. Bevor eine KI lernen kann, müssen Daten gefunden werden
Aus menschlicher Sicht erscheint das Internet als eine Sammlung von Webseiten. Für automatisierte Systeme stellt es sich anders dar.
Ein sogenannter Crawler kann Links folgen, Webseiten abrufen und ihre Inhalte automatisiert erfassen. Suchmaschinen arbeiten seit Jahrzehnten nach ähnlichen Grundprinzipien. Sie besuchen Seiten, analysieren deren Inhalte und erstellen daraus einen Index.
Data Mining geht noch einen Schritt weiter. Dabei werden große Datenbestände automatisiert untersucht, um Muster, Zusammenhänge oder andere Informationen daraus zu gewinnen. Text-und-Data-Mining bezeichnet entsprechend die automatisierte Analyse digitaler Texte und Daten.
Der Begriff ist älter als die heutige generative KI. Wissenschaftler nutzen solche Verfahren beispielsweise, um Tausende von Forschungsartikeln systematisch auszuwerten. Sprachwissenschaftler können Millionen von Texten untersuchen und Veränderungen im Sprachgebrauch sichtbar machen. In der medizinischen Forschung lassen sich große Datenbestände nach statistischen Zusammenhängen durchsuchen.
Generative KI hat diesem Verfahren jedoch eine völlig neue Dimension verliehen. Denn hier geht es nicht nur darum, etwas über einen Datenbestand herauszufinden. Die analysierten Inhalte können Teil eines Trainingsprozesses werden, aus dem ein Modell hervorgeht, das anschließend neue Texte, Bilder, Musik oder Videos erzeugt.
Damit verändert sich die wirtschaftliche Bedeutung des Ausgangsmaterials.
Ein Buch ist nicht mehr nur etwas, das ein Mensch lesen kann. Es kann zugleich als Trainingsmaterial dienen.
Ein Musikstück ist nicht nur ein Werk, das jemand hört. Es kann Daten über Rhythmus, Klang und musikalische Strukturen liefern.
Ein Video ist nicht nur etwas, das Menschen ansehen. Es zeigt einer Maschine, wie sich Menschen und Dinge im Laufe der Zeit bewegen.
Die digitale Kultur erhält damit eine zweite Nutzungsebene. Eine für Menschen. Und eine für Maschinen.
2. Ein Datensatz ist nicht einfach das Internet in einem Ordner
Wenn über Trainingsdaten gesprochen wird, entsteht manchmal der Eindruck, ein Unternehmen lade schlicht „das Internet“ herunter. Tatsächlich liegt zwischen einer Quelle und einem fertigen Trainingsdatensatz eine lange Kette von Entscheidungen.
Zunächst müssen Inhalte gefunden werden. Sie können aus öffentlich zugänglichen Webseiten, speziellen Archiven, lizenzierten Datenbeständen, öffentlichen Datensätzen, wissenschaftlichen Sammlungen oder eigenen Datenquellen stammen.
Danach beginnt die Auswahl. Nicht jedes gefundene Dokument ist brauchbar.
Webseiten enthalten Navigationselemente, Werbung, Cookiehinweise, automatisch erzeugte Seiten, Spam, doppelte Texte und technische Fragmente. Eine einzige Nachrichtenmeldung kann auf Dutzenden von Webseiten nahezu identisch erscheinen. Bücher liegen in mehreren Ausgaben vor. Bilder werden kopiert, verkleinert und erneut hochgeladen. Musikstücke erscheinen als Original, Liveaufnahme, Remix oder komprimierter Ausschnitt. Videoclips werden immer wieder neu geschnitten.
Deshalb gehört die sogenannte Deduplizierung zu den wichtigen Schritten der Datenaufbereitung. Ein Modell soll eine bestimmte Information nicht versehentlich tausendfach gewichten, nur weil dieselbe Datei an tausend verschiedenen Orten vorhanden war.
Danach folgen Qualitätsfilter.
Handelt es sich bei einem Text tatsächlich um Sprache oder nur um Zeichensalat? Ist ein Bild groß genug? Hat eine Audiodatei eine brauchbare Qualität? Ist ein Video technisch beschädigt? Welche Sprache wird verwendet? Welche Inhalte sollen ausgeschlossen werden?
Auch Sicherheitsfilter spielen eine Rolle. Personenbezogene Daten, gewaltverherrlichende oder sexuelle Darstellungen, Schadsoftware, Spam und andere unerwünschte Inhalte können je nach Modell und Verwendungszweck herausgefiltert oder gesondert behandelt werden.
Damit wird deutlich: Ein Trainingsdatensatz ist niemals vollkommen neutral. Er ist das Ergebnis zahlreicher Entscheidungen. Was aufgenommen wird, prägt das Modell. Was fehlt, ebenfalls.
3. Bücher geben einer KI etwas anderes als Webseiten
Nicht alle Daten haben denselben Wert. Das lässt sich besonders gut am Beispiel von Texten erkennen.
Das offene Web enthält eine enorme sprachliche Vielfalt. Foren zeigen Alltagssprache. Nachrichtenseiten liefern journalistische Texte. Wikipedia bietet strukturierte Sachinformationen. Produktseiten enthalten technische Beschreibungen. Blogs, Kommentare und soziale Netzwerke bilden informelle Kommunikation ab.
Bücher zeichnen sich jedoch durch andere Eigenschaften aus. Ein Roman kann über Hunderte von Seiten hinweg eine Erzählstruktur aufrechterhalten. Figuren entwickeln sich. Motive kehren wieder. Dialoge haben einen eigenen Rhythmus. Sachbücher erklären komplexe Zusammenhänge ausführlicher als kurze Webseiten. Fachliteratur enthält präzise Terminologie. Lehrbücher bauen Wissen systematisch aufeinander auf.
Für das Training eines Sprachmodells können solche Inhalte deshalb besonders wertvoll sein. Das erklärt zugleich, warum Bücher im Streit um Trainingsdaten eine so große Rolle spielen. Ihre Qualität macht sie attraktiv. Ihre Schutzwürdigkeit macht ihre Verwendung sensibel.
Ein öffentlich zugänglicher Text ist nicht automatisch gemeinfrei. Dass ein Mensch einen Artikel ohne Anmeldung lesen kann, bedeutet nicht, dass der Artikel frei von Rechten ist. Dasselbe gilt für digital verfügbare Bücher. Der technische Zugriff und die rechtliche Befugnis sind zwei verschiedene Dinge.
Genau deshalb enthält das europäische Urheberrecht besondere Regeln für das Text-und-Data-Mining. Dabei wird unter anderem zwischen wissenschaftlicher Forschung und anderen Formen der Analyse unterschieden. Bei bestimmten kommerziellen oder allgemeinen Nutzungen zu Mining-Zwecken können sich Rechteinhaber die entsprechende Nutzung ausdrücklich vorbehalten.
Im Onlinebereich spielt dabei die maschinenlesbare Form eines solchen Vorbehalts eine besondere Rolle. So entsteht eine ungewöhnliche Form der Kommunikation: nicht von Mensch zu Mensch, sondern von einer Webseite zu einem Crawler.
Eine Maschine ruft eine Seite auf und soll erkennen können:
Diese Inhalte dürfen unter bestimmten Bedingungen analysiert werden.
Oder:
Für diese Inhalte wurde die Nutzung zu Mining-Zwecken vorbehalten.
Das Urheberrecht beginnt damit, selbst eine technische Sprache zu sprechen.
4. Bei Bildern reicht das bloße Sammeln nicht aus
Ein Bildmodell benötigt nicht nur Bilder. Es muss möglichst auch verstehen, was darauf zu sehen ist. Genau deshalb waren sogenannte Bild-Text-Paare für die Entwicklung moderner generativer Systeme besonders wichtig.
Ein Foto zeigt beispielsweise einen Leuchtturm. Daneben oder auf derselben Webseite steht eine Beschreibung. Aus Millionen solcher Zuordnungen kann ein Modell statistisch lernen, welche visuellen Merkmale häufig mit Begriffen wie „Leuchtturm“, „Meer“, „Nacht“ oder „Sturm“ verbunden sind.
Diese Zuordnung ist entscheidend. Ohne sie könnte ein Modell zwar visuelle Muster lernen, wüsste jedoch nicht ohne Weiteres, welche sprachliche Beschreibung zu welchem Muster gehört. Die Qualität der Beschriftungen beeinflusst deshalb auch die Qualität des Lernprozesses.
Automatische Bildunterschriften können dabei helfen. Auch Metadaten lassen sich nutzen. Dateinamen, Alt-Texte und Texte im unmittelbaren Umfeld eines Bildes liefern zusätzliche Hinweise. Doch jeder dieser Wege ist fehleranfällig.
Ein Bild mit dem Dateinamen „urlaub.jpg“ sagt nur wenig aus. Eine automatisch erzeugte Bildbeschreibung kann eine Person falsch einordnen. Der Artikel, in den das Foto eingebettet ist, behandelt möglicherweise etwas völlig anderes.
Große Bilddatensätze entstehen deshalb nicht allein durch das Sammeln. Sie entstehen auch durch die Zuordnung von Bildern und Beschreibungen. Und jede falsche Zuordnung erhöht die Unsicherheit im Trainingsmaterial ein wenig.
Hinzu kommt die Herkunft. Ein Bild kann gemeinfrei sein. Es kann unter einer offenen Lizenz stehen. Es kann vom Betreiber des Modells selbst erstellt worden sein. Oder es kann sich um das geschützte Werk eines Fotografen oder Illustrators handeln.
Aus technischer Sicht können diese Dateien einem Computer zunächst gleichartig erscheinen. Rechtlich liegen Welten zwischen ihnen.
5. Musik muss erst in mathematische Strukturen übersetzt werden
Bei Audiodaten wird die Sache noch komplexer. Eine Musikdatei enthält nicht einfach eine Liste von Instrumenten und Noten. Sie besteht aus einer Wellenform, die sich im Laufe der Zeit verändert.
Damit ein Modell daraus lernen kann, muss das Audiomaterial in geeignete Repräsentationen überführt werden. Je nach Architektur können dabei unterschiedliche Verfahren zum Einsatz kommen. Ein System kann den zeitlichen Verlauf von Frequenzinformationen analysieren. Andere Modelle arbeiten mit komprimierten akustischen Repräsentationen oder speziellen Audio-Tokens. Zusätzliche Metadaten können das Genre, die Instrumente, die Stimmung oder andere Eigenschaften beschreiben.
Bei Musikgeneratoren ist außerdem entscheidend, welche Zuordnungen zwischen Text und Audio gelernt werden. Wenn jemand später schreibt:
„Langsame melancholische Klaviermusik mit sanften Streichern“,
muss das System während des Trainings gelernt haben, welche klanglichen Eigenschaften typischerweise mit solchen Begriffen verbunden sind. Dafür sind sorgfältig beschriebene Audiobestände besonders wertvoll.
Musik weist jedoch eine Besonderheit auf. Ein einzelner Titel kann mehrere rechtlich voneinander getrennte Ebenen enthalten.
Die Komposition. Den Liedtext. Die Aufnahme. Die künstlerischen Darbietungen der beteiligten Musiker. Metadaten. Vielleicht ein Coverbild.
Eine einzige MP3-Datei kann deshalb technisch eine Datei sein und rechtlich dennoch ein ganzes Rechtebündel darstellen. Für die Zusammenstellung von Datensätzen ist das eine erhebliche Herausforderung. Für Rechteinhaber sind diese Unterschiede wesentlich.
Denn eine Datenpipeline sieht zunächst nur Bytes. Das Recht sieht Werke und Beteiligte.
6. Videos sind die datenhungrigste Form des kulturellen Gedächtnisses
Ein Video enthält im Grunde mehrere Datentypen zugleich. Viele einzelne Bilder. Bewegung. Zeit. Häufig auch Sprache. Geräusche. Musik. Untertitel. Metadaten. Schnittfolgen.
Damit liefert ein Video einem Modell außergewöhnlich viele Informationen. Ein Videomodell kann daraus lernen, dass eine Tasse nach unten fällt. Dass Haare auf Wind reagieren. Dass sich mit der Drehung des Kopfes auch die Blickrichtung eines Menschen verändert. Dass sich die Landschaft im Kamerabild verschiebt, wenn ein Auto fährt.
Für generative Systeme ist dieses Wissen entscheidend. Ein Bildgenerator muss einen Hund für einen einzigen Augenblick plausibel darstellen. Ein Videogenerator muss verstehen, wie derselbe Hund zwei Sekunden später aussehen könnte. Genau darin liegt die enorme technische Herausforderung.
Video benötigt außerdem erheblich mehr Speicherplatz und Rechenleistung als Text. Das Transkript einer Stunde gesprochener Sprache ist vergleichsweise kompakt. Eine Stunde hochauflösendes Video enthält Hunderttausende von Einzelbildern und zusätzlich eine Tonspur.
Deshalb werden Videodaten häufig komprimiert, zeitlich ausgedünnt, segmentiert oder in speziell vorbereitete Ausschnitte zerlegt. Nicht jede Sekunde ist gleich wertvoll. Lange statische Passagen helfen einem Modell möglicherweise weniger als Szenen mit klar erkennbarer Bewegung. Untertitel können zusätzliche sprachliche Informationen liefern. Eine Szenenerkennung kann dabei helfen, einzelne Sequenzen voneinander zu trennen.
Auch hier findet also kein simples „Ansehen“ statt. Das Video wird technisch zerlegt. Die Maschine bekommt nicht den Filmabend. Sie bekommt Strukturen.
7. Data Mining ist nicht automatisch Training
Eine wichtige begriffliche Trennung geht in der öffentlichen Diskussion häufig verloren. Nicht jede automatisierte Datenanalyse dient dem Training eines generativen Modells.
Ein Unternehmen kann Millionen von Texten analysieren, um Trends zu erkennen. Eine Forschungseinrichtung kann wissenschaftliche Artikel nach bestimmten Genen durchsuchen. Eine Suchmaschine kann Webseiten indexieren. Ein Medienunternehmen kann Archive nach ähnlichen Bildern durchsuchen. All das kann Formen von Data Mining umfassen.
Das Training generativer Modelle ist ein spezieller, weitergehender Anwendungszweck. Diese Unterscheidung ist juristisch und gesellschaftlich relevant.
Denn ein Rechteinhaber kann eine bestimmte Analyse möglicherweise akzeptieren, eine andere hingegen nicht. Vielleicht soll ein Forschungsinstitut einen Buchbestand statistisch untersuchen dürfen. Das bedeutet nicht zwangsläufig, dass derselbe Bestand für ein kommerzielles Modell verwendet werden soll, das später Romane erzeugt.
Vielleicht darf eine Suchmaschine ein Foto indexieren. Damit ist jedoch noch nicht automatisch die Frage beantwortet, ob ein Bildgenerator daraus lernen darf.
Der technische Vorgang kann in beiden Fällen ähnlich sein. Der Zweck jedoch ist ein anderer. Und Zwecke spielen im Recht häufig eine entscheidende Rolle.
8. Das schwierigste Problem heißt Herkunft
Bei Datensätzen zählt deshalb nicht nur, was sie enthalten. Entscheidend ist auch, ob sich später noch nachvollziehen lässt, woher die einzelnen Inhalte stammen.
Hier setzt das Konzept der Data Provenance, also der Datenherkunft, an. Ein gut dokumentierter Trainingsbestand sollte im Idealfall die folgenden Fragen beantworten können:
Aus welcher Quelle stammt ein Teilbestand? Wann wurde er erfasst? Unter welchen Bedingungen? Gab es eine Lizenz? War der Inhalt gemeinfrei? Existierte ein Nutzungsvorbehalt? Wurde die Datei später entfernt? Welche Verarbeitungsschritte fanden statt?
Bei sehr großen Datensätzen ist das schwierig. Milliarden von Dokumenten lassen sich nicht wie Bücher in einem kleinen Bibliothekskatalog verwalten. Doch genau deshalb wird eine technische Daten-Governance immer wichtiger.
Ein modernes Modell braucht nicht nur Rechenleistung und möglichst viele Daten. Es braucht auch eine Datenbuchhaltung. Ohne sie wird jede spätere Korrektur mühsam.
Ein Rechteinhaber verlangt die Entfernung eines Werkes. In welchen Datensätzen und daraus abgeleiteten Versionen ist es enthalten?
Ein Datensatz enthält problematische persönliche Informationen. Welche daraus abgeleiteten Datensatzversionen sind betroffen?
Eine Quelle ändert ihre Nutzungsbedingungen. In welchen Trainingspipelines wurde sie verwendet?
Solche Fragen zeigen, warum Herkunftsinformationen nicht bloß juristische Bürokratie sind. Sie gehören zu einer guten technischen Architektur.
9. Löschen ist nach dem Training schwieriger als vor dem Training
Bei einer klassischen Datenbank ist das Löschen vergleichsweise leicht nachzuvollziehen. Eine Zeile wird entfernt. Eine Datei verschwindet.
Bei einem trainierten neuronalen Netz ist die Situation eine andere. Das Modell hat statistische Zusammenhänge aus den Trainingsdaten gelernt. Ein einzelnes Dokument liegt im fertigen Modell nicht unbedingt als sauber abtrennbare Datei vor.
Deshalb ist es etwas anderes, einen Datensatz vor dem Training zu entfernen, als seinen Einfluss nachträglich aus einem bereits trainierten Modell zu tilgen. Hier ist ein Forschungsgebiet entstanden, das als Machine Unlearning bezeichnet wird.
Die Idee klingt einfach: Ein Modell soll bestimmte erlernte Informationen wieder vergessen. In der Praxis ist das erheblich komplizierter.
Manchmal kann ein erneutes Training notwendig sein. Andere Verfahren versuchen, bestimmte Einflüsse gezielt abzuschwächen. Doch nicht für jede Modellarchitektur gibt es einen perfekten digitalen Radiergummi.
Das macht Datenhygiene vor dem Training umso wichtiger. Was gar nicht erst aufgenommen wird, muss später nicht mühsam wieder entfernt werden.
10. Synthetische Daten verändern die nächste Generation des Problems
Interessanterweise müssen zukünftige KI-Systeme nicht ausschließlich aus Daten lernen, die von Menschen erzeugt wurden. Modelle können selbst Trainingsmaterial erzeugen.
Ein Sprachmodell produziert Texte. Ein Bildgenerator erstellt künstliche Szenen. Simulationssysteme erzeugen ganze virtuelle Welten.
Solche synthetischen Daten können wertvoll sein. Sie lassen sich gezielt für seltene Situationen erzeugen. Persönliche Daten können vermieden werden. Bestimmte Eigenschaften eines Trainingsbestandes lassen sich besser kontrollieren.
Doch auch hier entstehen Risiken. Wenn Modelle immer stärker aus den Ausgaben anderer Modelle lernen, können sich Fehler vervielfältigen. Bestimmte sprachliche Muster werden überrepräsentiert. Die Vielfalt nimmt ab. Fehler werden nicht nur übernommen, sondern weitergegeben und möglicherweise verstärkt.
Ein Modell lernt dann immer weniger von der Welt und immer mehr von früheren Modellen. Das wäre wie eine Bibliothek, in der jedes neue Buch nur noch Zusammenfassungen der bereits vorhandenen Bücher enthält.
Irgendwann wird das Regal voller. Das Wissen darin aber nicht unbedingt reicher.
Deshalb dürfte hochwertiges menschliches Ausgangsmaterial seinen Wert behalten. Vielleicht wird dieser Wert sogar steigen.
11. Die Zukunft der KI könnte weniger von der Datenmenge als von der Datenqualität abhängen
Die ersten großen Trainingswellen folgten häufig einer einfachen Logik: mehr Daten. Mehr Rechenleistung. Größere Modelle.
Doch dieser Ansatz kann nicht unbegrenzt wachsen. Das offene Internet ist groß, aber nicht grenzenlos. Gute Daten sind seltener als beliebige Daten.
Ein sorgfältig redigiertes Fachbuch kann für bestimmte Fähigkeiten wertvoller sein als Tausende automatisch erzeugter Webseiten. Ein hochwertig beschrifteter Bildbestand kann nützlicher sein als Millionen schlecht zugeordneter Bilder. Eine professionell produzierte Mehrspuraufnahme enthält andere Informationen als ein stark komprimierter Musikausschnitt. Ein sorgfältig dokumentierter Videodatensatz kann wertvoller sein als eine unstrukturierte Masse von Daten.
Damit könnte sich der Wettbewerb verändern. Nicht automatisch das Unternehmen mit dem leistungsfähigsten Sammelapparat gewinnt. Sondern dasjenige, das weiß, welche Daten es besitzt, woher sie stammen und warum sie sich für ein bestimmtes Modell eignen.
Qualität. Rechteklarheit. Vielfalt. Aktualität. Dokumentation.
Diese Eigenschaften könnten zu ebenso wichtigen Ressourcen werden wie die reine Datenmenge.
12. Daten sind keine abstrakte Naturressource
In technischen Diskussionen werden Daten gern wie Rohstoffe beschrieben. Daten werden gesammelt. Daten werden bereinigt. Daten werden verarbeitet. Daten fließen durch Pipelines.
Diese Sprache ist praktisch. Aber sie kann etwas verbergen.
Ein großer Teil der wertvollsten Trainingsdaten wurde nicht zu dem Zweck erzeugt, dass eine Maschine daraus lernt. Ein Autor schrieb einen Roman für seine Leser. Eine Musikerin nahm ein Lied für ihre Zuhörer auf. Ein Fotograf wartete auf ein bestimmtes Licht. Ein Filmteam baute eine Szene. Ein Journalist führte ein Interview. Ein Entwickler schrieb eine Dokumentation für andere Entwickler.
Erst später wurden diese Werke zugleich zu potenziellem Trainingsmaterial. Genau deshalb ist die Debatte so schwierig.
Aus technischer Perspektive sind es Datenpunkte. Aus menschlicher Perspektive sind sie das Ergebnis von Arbeit. Beides ist gleichzeitig wahr.
Eine verantwortungsvolle KI-Entwicklung muss beides zusammendenken. Sie darf Daten nicht verklären, sollte sie aber auch nicht so behandeln, als seien sie einfach in der Natur vorhanden gewesen.
Das Internet ist kein Wald, in dem Texte wie Blätter wachsen. Menschen haben sie geschrieben.
Videos sind keine zufälligen Ablagerungen. Jemand hat sie gedreht.
Musikdateien entstehen nicht aus statistischem Rauschen. Bevor eine Maschine ihre Muster analysieren kann, muss jemand eine musikalische Entscheidung getroffen haben.
Vielleicht liegt genau darin die wichtigste Frage für die nächste Phase der künstlichen Intelligenz.
Nicht:
Wie können wir noch mehr Daten sammeln?
Sondern:
Wie können wir besser nachvollziehen, welche Daten wir verwenden, woher sie stammen und unter welchen Bedingungen Maschinen daraus lernen dürfen?
Die Zukunft leistungsfähiger KI wird weiterhin Daten benötigen. Sehr viele Daten.
Doch Reife zeigt sich möglicherweise nicht daran, wie schnell eine Maschine das Wissen der Welt aufnehmen kann. Sondern daran, wie sorgfältig wir mit dem Weg umgehen, auf dem dieses Wissen zu ihr gelangt.
Denn zwischen einem Buch und einem Modell liegt mehr als ein Download. Zwischen einer Aufnahme und einem Trainingslauf liegt mehr als eine Datei.
Dazwischen liegen Herkunft, Auswahl, Rechte, Technik und Verantwortung. Und vielleicht wird genau diese unsichtbare Strecke eines Tages ebenso wichtig sein wie die beeindruckende Antwort, die am Ende aus der Maschine kommt.
Weiterführende Informationen
Quellenhinweis: Einzelne Fakten, Einschätzungen und Prognosen dieses Beitrags stützen sich auf Veröffentlichungen der nachfolgend genannten Unternehmen und Institutionen. Die Links dienen zugleich der weiterführenden Information.
IBM – Was ist multimodale KI?
Die Seite erläutert, wie Text, Bilder, Audio und Video durch Merkmalsextraktion, gemeinsame Einbettungsräume sowie räumliche und zeitliche Ausrichtung für multimodales Lernen zusammengeführt werden.
https://www.ibm.com/de-de/think/topics/multimodal-ai
Bundesministerium der Justiz und für Verbraucherschutz und Bundesamt für Justiz – Urheberrechtsgesetz
Der Gesetzestext unterscheidet in § 44b und § 60d allgemeines Text-und-Data-Mining von wissenschaftlicher Forschung und regelt den maschinenlesbaren Nutzungsvorbehalt für online zugängliche Werke.
https://www.gesetze-im-internet.de/urhg/BJNR012730965.html?level=1
CISPA Helmholtz-Zentrum für Informationssicherheit – Wie Maschinen das Vergessen lernen
Die Forschungsseite erklärt, weshalb sich einzelne Trainingsdatensätze und ihre Modellwirkungen nicht einfach spurlos entfernen lassen, und stellt Machine-Unlearning-Verfahren wie SISA und Graph Eraser vor.
https://cispa.de/machine-unlearning